








使用 dense_rank() 处理并列排名的核心做法是在 over 子句中指定 order by 排序字段,它会为每一行生成一个排名,相同值的行获得相同排名,且后续排名连续不跳跃。例如对分数进行降序排列时,两个第一名后直接是第二名,不会出现名次空缺。这种窗口函数适用于需要紧凑排名序列的场景,如体育比赛积分或成绩等级划分。

DENSE_RANK() 与 RANK() 在并列时的区别是什么
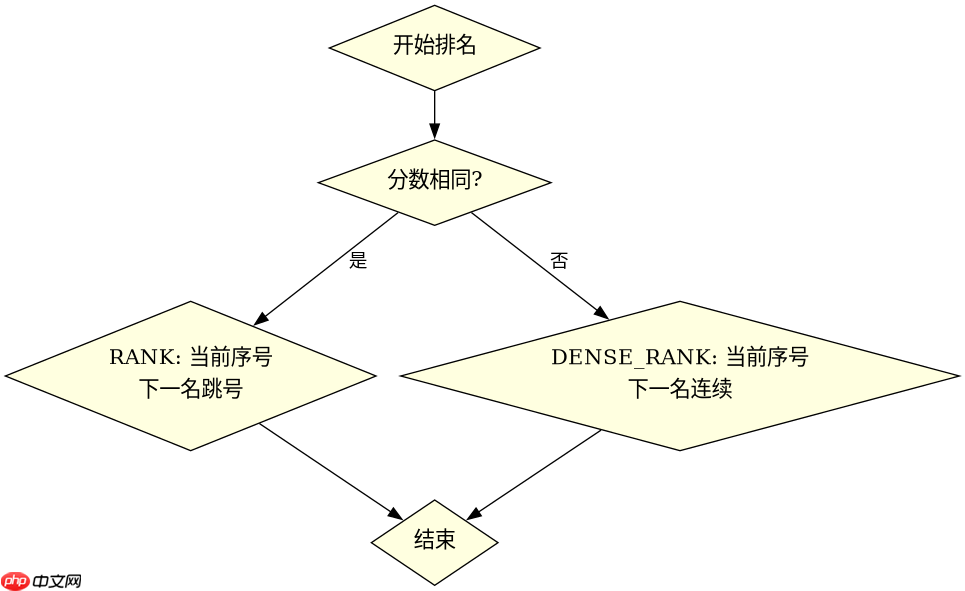
两者都处理并列情况,但 RANK() 会在并列后跳过后续名次,而 DENSE_RANK() 保持连续。例如三个并列第一后,RANK() 的下一个是第四名,DENSE_RANK() 的下一个是第二名。选择哪种取决于业务是否允许名次断层。
SELECT name, score, RANK() OVER (ORDER BY score DESC) as r_rank, DENSE_RANK() OVER (ORDER BY score DESC) as d_rank FROM scores;
预期结果:若输入为 Alice(90), Bob(90), Charlie(80),则 Alice 和 Bob 的 r_rank 均为 1,Charlie 为 3;而 d_rank 中 Charlie 为 2。
如何按组内条件使用 DENSE_RANK() 进行分组排名
在 OVER 子句中加入 PARTITION BY 可实现分组内的独立排名。例如按部门分组计算员工薪资排名,每个部门内部从 1 开始重新计数,互不影响。这适用于多实体对比场景,如各班级最高分学生筛选。

SELECT dept, name, salary, DENSE_RANK() OVER (PARTITION BY dept ORDER BY salary DESC) as dept_rank FROM employees;
预期结果:若输入为 DeptA(Alice, 5000), DeptA(Bob, 5000), DeptB(Charlie, 6000),则 Alice 和 Bob 的 dept_rank 均为 1,Charlie 也为 1,因为分区独立。
DENSE_RANK() 遇到空值(NULL)时如何处理排名
当排序字段包含 NULL 时,默认情况下 NULL 被视为最小值排在最前(升序)或最后(降序),具体取决于 ORDER BY 的方向。在降序排名中,NULL 通常排在末尾,不影响非空值的连续排名。若需将 NULL 视为特定值,可先用 COALESCE 转换再排名。
















