








在c# linq联表查询分页时,避免主记录重复的核心做法是先在内存中获取去重后的主键集合,再基于该集合进行数据库分页。具体而言,先通过 .select() 提取唯一的主键id,使用 .distinct() 去重后调用 .take() 和 .skip() 完成内存分页,最后将得到的id列表传回数据库查询中进行二次过滤。这样做能确保即使关联表存在一对多关系导致sql结果集膨胀,最终返回给前端的主记录依然是不重复且符合分页逻辑的。

LINQ联表查询为何会导致主记录重复
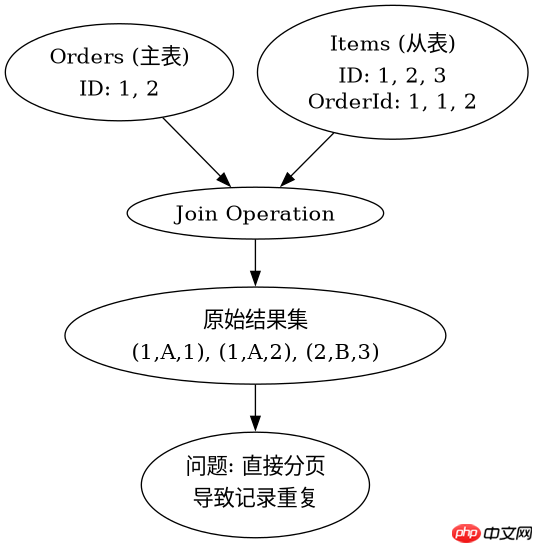
当使用LINQ进行一对多联表查询时,数据库会执行内连接(Inner Join),如果主表的一条记录对应关联表的N条记录,查询结果集中主表的数据就会重复出现N次。例如,一个订单可能包含多个订单项,直接对这种展开的结果集进行分页,会导致同一个订单出现在不同的页码中,或者因为总行数虚高而导致分页总数计算错误。
using System;
using System.Collections.Generic;
using System.Linq;

public class OrderItem { public int Id; public int OrderId; }
public class Order { public int Id; public string Name; }

class Program {
    static void Main() {
        var orders = new List<Order> {
            new Order { Id = 1, Name = "A" },
            new Order { Id = 2, Name = "B" }
        };
        var items = new List<OrderItem> {
            new OrderItem { Id = 1, OrderId = 1 },
            new OrderItem { Id = 2, OrderId = 1 },
            new OrderItem { Id = 3, OrderId = 2 }
        };

        // 模拟联表查询导致的重复
        var joined = from o in orders
                     join i in items on o.Id equals i.OrderId
                     select new { Order = o, Item = i };

        Console.WriteLine($"Total Rows: {joined.Count()}"); // 输出 3
        foreach (var row in joined) {
            Console.WriteLine($"Order: {row.Order.Name}, Item: {row.Item.Id}");
        }
    }
}
上述代码展示了典型的重复场景:订单A对应两个订单项,因此在结果集中出现了两次。若直接对此结果集进行分页,第一页可能拿到订单A的两个实例,第二页拿到订单B的一个实例,这显然不符合业务需求。

如何基于主键集合实现正确的分页
解决重复问题的关键在于“先取主键,再查详情”。我们需要利用LINQ的延迟执行特性,分两步构建查询。第一步在内存或数据库中筛选出所有涉及到的主键ID并去重;第二步对这些ID进行分页截取;第三步用截取后的ID列表去查询完整的实体对象。这种方法虽然会产生两次数据库交互(或一次复杂的子查询),但能保证分页数据的准确性。

using System;
using System.Collections.Generic;
using System.Linq;

public class OrderItem { public int Id; public int OrderId; }
public class Order { public int Id; public string Name; }

class Program {
    static void Main() {
        var orders = new List<Order> {
            new Order { Id = 1, Name = "A" },
            new Order { Id = 2, Name = "B" },
            new Order { Id = 3, Name = "C" }
        };
        var items = new List<OrderItem> {
            new OrderItem { Id = 1, OrderId = 1 },
            new OrderItem { Id = 2, OrderId = 1 },
            new OrderItem { Id = 3, OrderId = 2 },
            new OrderItem { Id = 4, OrderId = 3 }
        };

        int pageSize = 2;
        int pageIndex = 0;

        // 1. 获取去重后的主键ID
        var distinctIds = (from o in orders
                           join i in items on o.Id equals i.OrderId
                           select o.Id).Distinct().ToList();

        // 2. 对主键ID进行分页
        var pagedIds = distinctIds.Skip(pageIndex * pageSize)
                                  .Take(pageSize).ToList();

        // 3. 根据分页后的ID查询完整记录
        var result = from o in orders
                     where pagedIds.Contains(o.Id)
                     select o;

        Console.WriteLine($"Page {pageIndex} Results:");
        foreach (var order in result) {
            Console.WriteLine($"Order: {order.Name}");
        }
    }
}
运行上述代码,首先 distinctIds 会得到 [1, 2, 3]。接着 pagedIds 根据页码和大小截取出 [1, 2]。最后查询只返回ID为1和2的订单,完美避免了重复,且每页数量固定为主记录的数量。
当主记录没有关联数据时会发生什么
在上述方案中,如果某条主记录在关联表中没有任何匹配项,它会被自然排除在结果之外。这是因为我们使用的是内连接(Join)逻辑,只有存在关联数据的记录才会产生ID。如果业务要求必须保留这些“孤儿”主记录,需要在第一步去重前处理空值,或者改用左连接(Left Join)并在后续步骤中手动合并无关联数据的记录,但这会增加逻辑复杂度。















