








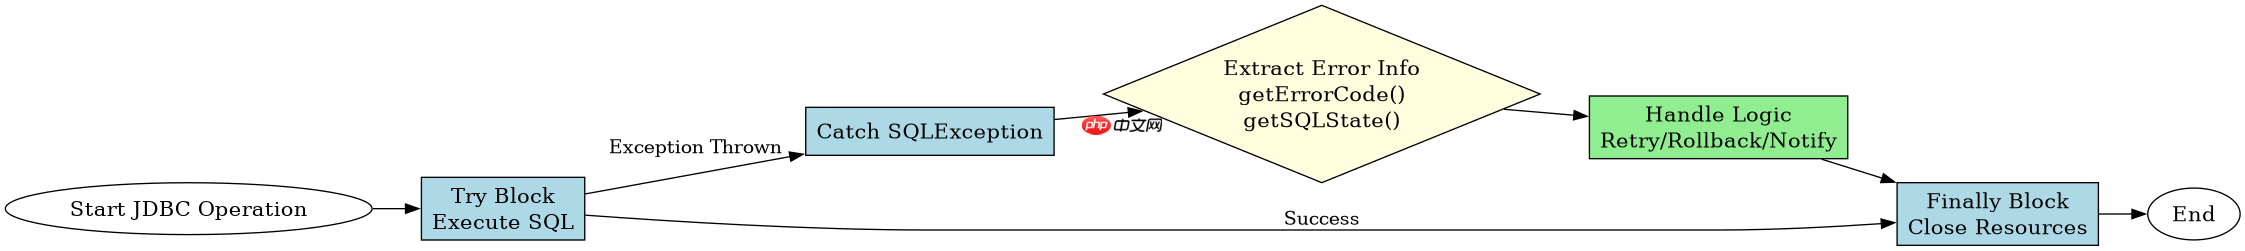
java jdbc 处理 sql 异常的核心方式是使用 try-catch-finally 结构捕获 sqlexception,并在 finally 块中确保数据库资源(如 connection、statement、resultset)被正确关闭。通过检查 sqlexception 的 geterrorcode() 和 getnextexception() 方法,可以区分不同类型的数据库错误(如主键冲突、语法错误),并根据业务需求决定是重试、回滚事务还是向用户返回友好提示。
如何捕获并解析 SQLException 的具体信息?
在 JDBC 操作中,当 SQL 执行失败时,驱动程序会抛出 SQLException。开发者需要捕获该异常,并通过其提供的 API 获取详细的错误码(error code)、SQL 状态码(SQL state)以及具体的错误消息。这些信息对于定位问题是发生在客户端参数绑定阶段,还是服务端执行阶段至关重要。例如,MySQL 驱动通常会在 getErrorCode() 中返回特定的数字代码(如 1062 表示重复键值),而 getNextException() 可用于处理由多个语句组成的批处理操作中的链式异常。
import java.sql.*;

public class JdbcExceptionHandler {
    public static void handleInsert(Connection conn) {
        String sql = "INSERT INTO users (username, email) VALUES (?, ?)";
        PreparedStatement pstmt = null;
        try {
            pstmt = conn.prepareStatement(sql);
            pstmt.setString(1, "john_doe");
            pstmt.setString(2, "john@example.com");
            pstmt.executeUpdate();
        } catch (SQLException e) {
            // 获取错误码和SQL状态
            int errorCode = e.getErrorCode();
            String sqlState = e.getSQLState();
            System.out.println("Error Code: " + errorCode);
            System.out.println("SQL State: " + sqlState);
            System.out.println("Message: " + e.getMessage());

            // 根据错误码做特定处理
            if (errorCode == 1062) { // MySQL Duplicate Entry
                System.out.println("User already exists.");
            }
        } finally {
            if (pstmt != null) {
                try { pstmt.close(); } catch (SQLException e) { e.printStackTrace(); }
            }
        }
    }
}
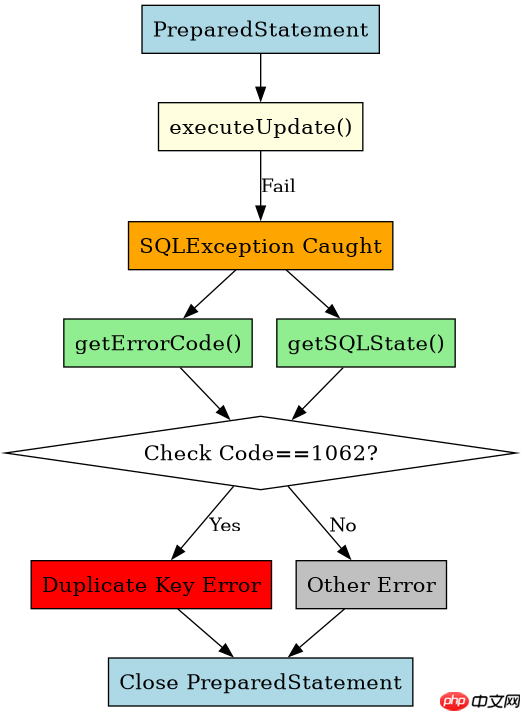
上述代码展示了标准的异常捕获流程。首先尝试执行插入操作,若发生 SQLException,则立即提取 errorCode 和 sqlState。对于 MySQL 数据库,错误码 1062 明确指示了唯一约束冲突。这种基于错误码的判断比单纯依赖消息字符串更可靠,因为消息可能因语言设置而异。最后,无论是否发生异常,finally 块都会确保 PreparedStatement 被关闭,防止连接泄漏。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何处理批量操作中的部分失败?
在使用 addBatch() 和 executeBatch() 进行批量数据处理时,单个语句的失败可能导致整个批次中断或产生部分成功的情况。JDBC 规范允许驱动程序在遇到错误时选择停止执行剩余语句,或者继续执行并记录错误。为了准确处理这种情况,开发者必须检查 executeBatch() 返回的 int[] 数组。该数组中的每个元素代表对应批次语句的执行结果:正数表示受影响的行数,SUCCESS_NO_INFO (-2) 表示成功但无具体行数,EXECUTE_FAILED (-3) 表示该语句执行失败。此外,如果驱动程序支持 Statement.RETURN_GENERATED_KEYS,还需要注意生成的键可能在部分失败时不完整。

import java.sql.*;

public class BatchExceptionHandler {
    public static void handleBatchInsert(Connection conn) throws SQLException {
        String sql = "INSERT INTO logs (message) VALUES (?)";
        Statement stmt = conn.createStatement();

        // 添加多条数据
        for (int i = 0; i < 5; i++) {
            stmt.addBatch("INSERT INTO logs (message) VALUES ('Log ' + " + i + ")");
        }

        try {
            int[] results = stmt.executeBatch();
            for (int i = 0; i < results.length; i++) {
                if (results[i] == Statement.EXECUTE_FAILED) {
                    System.out.println("Batch item " + i + " failed.");
                    // 获取导致失败的异常
                    SQLException ex = stmt.getConnection().createStatement().executeQuery("SELECT 1").getMoreResults() ? null : null;
                    // 实际中应通过遍历或单独查询获取具体异常,这里简化展示逻辑
                } else {
                    System.out.println("Batch item " + i + " affected rows: " + results[i]);
                }
            }
        } catch (BatchUpdateException bue) {
            System.out.println("Batch update exception occurred.");
            int[] partialResults = bue.getUpdateCounts();
            for (int i = 0; i < partialResults.length; i++) {
                System.out.println("Item " + i + " status: " + partialResults[i]);
            }
        }
    }
}在批量操作中,即使发生了异常,executeBatch() 也可能返回一个包含部分成功结果的数组,或者抛出 BatchUpdateException。通过捕获 BatchUpdateException 并调用其 getUpdateCounts() 方法,可以精确知道哪些索引位置的语句失败了。这对于实现“跳过错误继续执行”或“仅重试失败项”的业务逻辑非常关键。需要注意的是,不同数据库驱动对批量失败的处理策略可能不同,因此始终检查返回数组和异常对象是最佳实践。
如何在事务中根据异常类型决定是否回滚?
当 JDBC 连接处于自动提交关闭(autoCommit=false)的事务模式时,SQL 异常的发生直接影响事务的最终状态。并非所有异常都需要回滚事务。例如,某些非致命错误或预期内的业务规则违反(如库存不足)可能只需要记录日志而不必撤销已执行的更改。然而,对于数据完整性破坏、连接断开或系统级错误,必须调用 conn.rollback() 以恢复数据一致性。开发者应根据 SQLException 的类别(如 SQL State 分类)来决定是提交(commit())还是回滚。同时,在回滚后,通常需要重新初始化连接或语句对象,因为处于异常状态的连接可能无法直接复用。


















