








crsctl 检查集群时间偏移量是否超限
在 oracle rac 环境中,两节点网络时钟不同步会导致 crs-01846 或 ora-27513 等错误,根本原因是节点间时间差超过了 cluster_interconnect_hba 或操作系统内核允许的最大 ntp 偏差。要解决这个问题,必须确保所有节点都配置了相同的 ntp 服务器,并验证当前时间偏移量是否在 oracle.crs.skew_limit_ms(默认通常为 1000ms)以内。
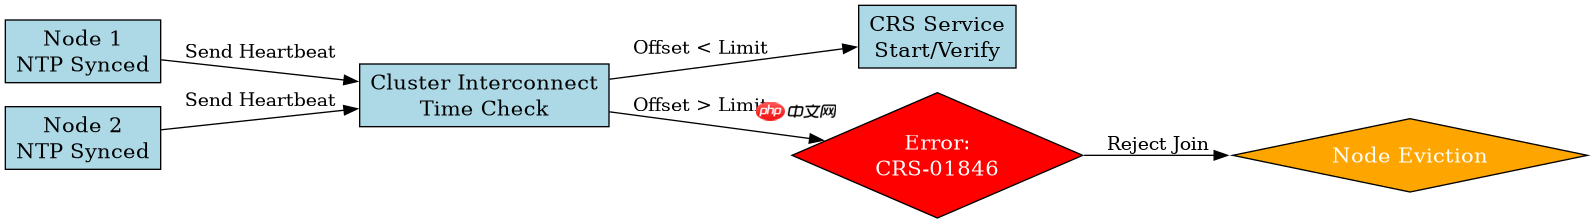
首先,需要确认当前集群各节点的时间同步状态。可以使用 clsnodes 或 olsnodes -t 查看节点状态,但更直接的是检查操作系统的 NTP 服务状态以及 <code>chronyd 或 ntpd 的同步源。如果时间差过大,即使重启 CRS 也无法自动修复,因为 CRS 启动时会校验时间一致性。
systemctl status chronyd
chronyc sources -v
ocrsctl query crs activeversion
预期结果:如果 chronyc sources 显示同步源为 *` 或 <code>`=,且偏置量(Offset)在毫秒级,则说明系统层同步正常。如果偏置量超过 1000ms,则需要手动调整或强制同步。
如何强制同步并重置 CRS 时间感知
当发现时间不同步时,最直接的做法是停止 CRS 服务,手动校正系统时间,然后重新启动 CRS。Oracle 建议在时间校正后,使用 crsctl stop crs 和 crsctl start crs 来让集群重新感知新的时间基准,避免缓存旧的时间戳导致的心跳失败。
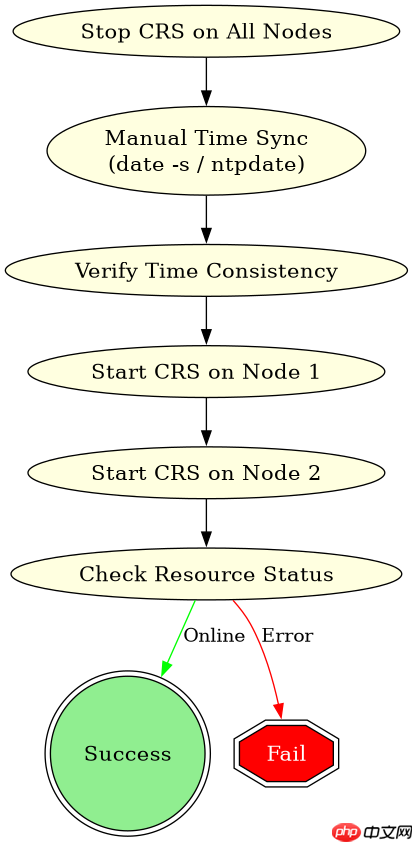

具体操作步骤如下:首先在两个节点上分别停止 CRS 服务,确保没有进程在运行。然后,在每个节点上使用 date -s 命令或 NTP 客户端强制设置正确时间。最后,按顺序启动 CRS 服务。注意,必须在所有节点时间一致后再启动 CRS,否则可能导致 quorum 丢失或脑裂。
# Node 1
crsctl stop crs
date -s "2023-10-27 10:00:00"
# Node 2
crsctl stop crs
date -s "2023-10-27 10:00:00"
# Node 1 (Start first)
crsctl start crs
# Node 2 (Start after Node 1 is up)
crsctl start crs
预期结果:crsctl stat res -t 显示所有资源 ONLINE,且 clsecho -r time 无异常报错。如果启动后仍报错,需检查 $GRID_HOME/log/<hostname>/alerthostname.log</hostname> 中是否有 CRS-01846 错误。
基于 skew_limit_ms 参数的具体调整问题
如果 NTP 同步正常但时间仍有微小波动导致 CRS 报错,可以通过调整 oracle.crs.skew_limit_ms 参数来放宽时间容忍度。该参数默认值为 1000 毫秒,在某些高延迟网络或 NTP 精度不足的环境中,适当增加该值可以避免因瞬时时间跳变导致的节点驱逐。
修改该参数需要使用 crsctl modify css 命令。例如,将容忍度调整为 2000 毫秒:
crsctl modify css -m skew_limit_ms=2000
预期结果:修改后,集群对时间偏差的容忍度提高,轻微的时间抖动不再触发 CRS-01846 错误。但需注意,过大的 skew limit 可能掩盖真正的时钟漂移问题,建议仅在 NTP 无法达到更高精度时作为临时措施。




















