








java synchronized 锁竞争激烈时,优化核心在于减少持有锁的时间、缩小锁的粒度以及利用无锁数据结构。具体做法包括将大对象锁拆分为小对象锁(分段锁),使用 volatile 变量配合 cas 操作实现无锁化更新,或者引入 reentrantlock 等显式锁机制以支持更细粒度的控制。通过降低线程阻塞概率和避免上下文切换,可以显著提升高并发场景下的吞吐量。
synchronized 在竞争时的性能瓶颈是什么
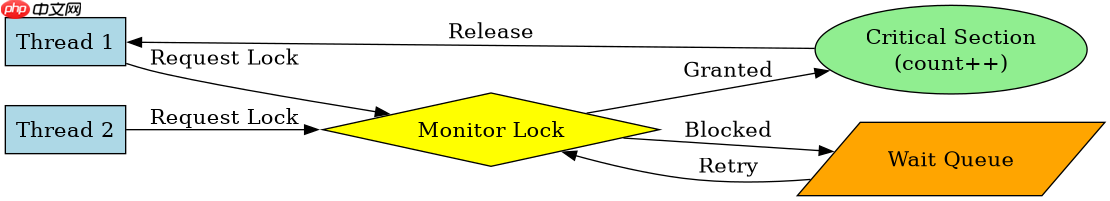
当多个线程同时请求同一个对象的监视器锁时,JVM 会触发锁升级或自旋等待,导致线程挂起和唤醒,产生巨大的系统开销。这种开销主要来源于内核态与用户态的切换以及线程状态的频繁变更。在高竞争环境下,synchronized 的内置锁机制无法像显式锁那样提供公平性策略或可中断尝试获取锁的能力,从而成为性能瓶颈。
public class LockContentionDemo {
    private int count = 0;

    public synchronized void increment() {
        // 临界区代码,所有线程必须排队进入
        count++;
    }

    public static void main(String[] args) throws InterruptedException {
        LockContentionDemo demo = new LockContentionDemo();
        Thread[] threads = new Thread[10];
        for (int i = 0; i < 10; i++) {
            threads[i] = new Thread(() -> {
                for (int j = 0; j < 100000; j++) {
                    demo.increment();
                }
            });
            threads[i].start();
        }
        for (Thread t : threads) {
            t.join();
        }
        System.out.println("Final Count: " + demo.count);
    }
}
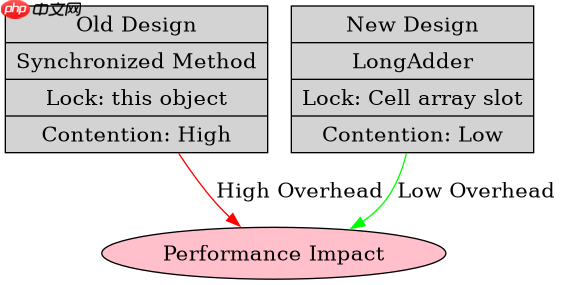
上述代码展示了典型的锁竞争场景。每个线程调用 increment() 方法时,都必须获取 this 对象的监视器锁。如果线程数多于 CPU 核心数,大量线程将在 WAITING 或 TIMED_WAITING 状态中消耗时间,最终输出的 count 值虽然正确,但执行耗时显著增加。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何通过缩小锁粒度来优化竞争
优化锁竞争最直接的方法是缩小锁的作用范围,即只锁定真正需要保护的数据部分,而不是整个对象或方法。这可以通过将一个大数组或集合拆分为多个独立的锁对象来实现,例如 Java 8 之前 ConcurrentHashMap 的分段锁设计,或者在 Java 8+ 中使用 LongAdder 替代 AtomicInteger。通过将热点数据分散到不同的锁上,线程只需竞争局部资源,从而大幅降低冲突概率。
import java.util.concurrent.atomic.LongAdder;

public class OptimizedCounter {
    private LongAdder counter = new LongAdder();

    public void increment() {
        // 无锁操作,内部维护多个累加单元,仅在 sum() 时合并
        counter.increment();
    }

    public long getCount() {
        return counter.sum();
    }

    public static void main(String[] args) throws InterruptedException {
        OptimizedCounter optimized = new OptimizedCounter();
        Thread[] threads = new Thread[10];
        for (int i = 0; i < 10; i++) {
            threads[i] = new Thread(() -> {
                for (int j = 0; j < 100000; j++) {
                    optimized.increment();
                }
            });
            threads[i].start();
        }
        for (Thread t : threads) {
            t.join();
        }
        System.out.println("Optimized Count: " + optimized.getCount());
    }
}
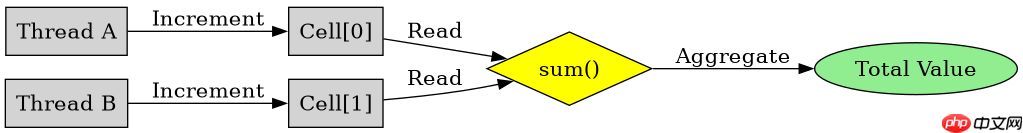
该示例使用 LongAdder 替代了之前的同步计数器。LongAdder 内部维护了一个 Cell 数组,每个线程在递增时只竞争自己所在槽位的锁,只有在调用 sum() 时才进行全局合并。这种方式在高并发写入场景下,避免了线程间的直接锁竞争,性能远优于 synchronized 修饰的方法。
LongAdder 的 sum() 方法返回结果是否实时准确
LongAdder 的 sum() 方法返回的是所有内部 Cell 值的总和,但在多线程并发递增的过程中,这个返回值并非绝对实时一致。由于 sum() 需要遍历并累加所有活跃槽位,如果在遍历过程中其他线程仍在修改槽位值,可能会读到部分新值和部分旧值,导致结果存在微小的延迟误差。然而,对于大多数业务场景而言,这种最终一致性已足够,且其获取总成本的开销远低于每次递增都进行全局同步。



















