








排查java字节流与字符流的编码问题,核心在于确认数据源的实际编码、读取时的解码方式以及写入时的编码设置是否一致。具体做法是:在创建inputstreamreader或outputstreamwriter时显式指定charset(如utf-8),避免依赖平台默认编码;若处理原始字节流,需先通过bom检测或业务约定确定编码再转换;对于乱码,应逐层检查文件头、网络报文和jvm参数中的编码配置。
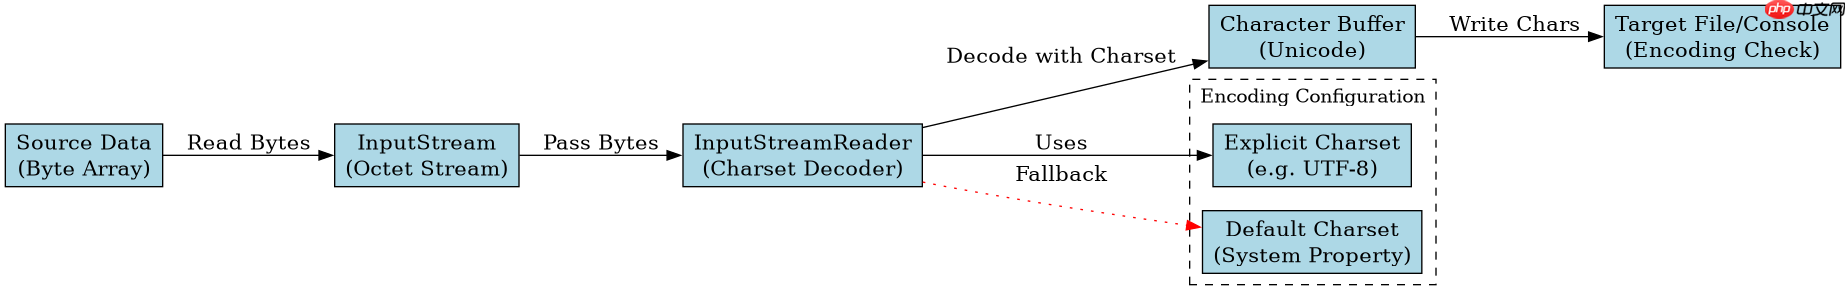
如何确保InputStreamReader使用正确的字符集解码字节
要解决字节流到字符流的解码错误,必须在构造InputStreamReader时传入明确的Charset对象。如果不指定,Java会使用System.getProperty("file.encoding")作为默认值,这在跨平台部署时极易导致乱码。通过显式指定如"UTF-8",可以强制JVM按照该标准将字节序列转换为Unicode字符,从而消除因环境差异引起的解析偏差。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class EncodingCheck {
    public static void main(String[] args) throws IOException {
        // 模拟UTF-8编码的字节数组
        byte[] bytes = "你好".getBytes(StandardCharsets.UTF_8);

        // 正确做法:显式指定UTF-8解码
        try (InputStream is = new ByteArrayInputStream(bytes);
             InputStreamReader reader = new InputStreamReader(is, StandardCharsets.UTF_8)) {

            char[] buffer = new char[10];
            int len = reader.read(buffer);
            String result = new String(buffer, 0, len);
            System.out.println("Decoded: " + result); // 输出: 你好
        }

        // 错误做法:依赖默认编码,可能在Windows GBK环境下产生乱码
        try (InputStream is = new ByteArrayInputStream(bytes);
             InputStreamReader reader = new InputStreamReader(is)) {
            char[] buffer = new char[10];
            int len = reader.read(buffer);
            String wrongResult = new String(buffer, 0, len);
            System.out.println("Default Decoded: " + wrongResult);
        }
    }
}
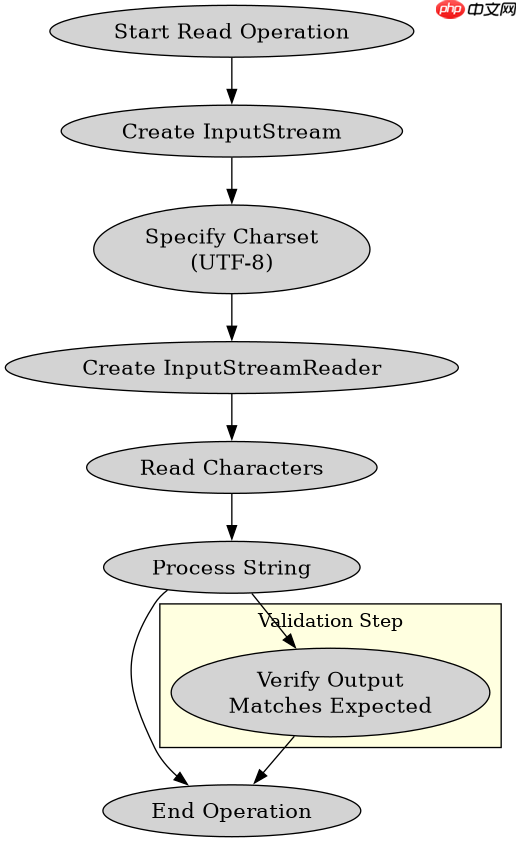
上述代码展示了两种解码方式的对比。第一段使用StandardCharsets.UTF_8显式声明,确保在任何平台上都能正确还原“你好”二字。第二段未指定编码,若运行环境默认编码为GBK,则UTF-8的多字节序列会被错误拆分,导致输出类似“ä½ å¥½”的乱码。排查时应优先检查此类构造函数的参数传递。
立即学习“Java免费学习笔记(深入)”;

如何处理带有BOM头的文本文件读取
当读取包含BOM(Byte Order Mark)的文件时,若未正确处理,BOM字符会作为第一个有效字符出现在字符串中,导致后续逻辑判断失败。解决方法是在读取后手动移除U+FEFF字符,或使用支持BOM感知的解码器。在Java 11及以上版本,可以使用InputStreamReader的构造函数自动跳过BOM,或者在业务层进行清洗。

import java.io.*;
import java.nio.charset.StandardCharsets;

public class BOMHandler {
    public static void main(String[] args) throws IOException {
        // 模拟带UTF-8 BOM的文件内容
        byte[] bomBytes = new byte[] {(byte)0xEF, (byte)0xBB, (byte)0xBF};
        byte[] content = "Hello".getBytes(StandardCharsets.UTF_8);
        byte[] fullContent = new byte[bomBytes.length + content.length];
        System.arraycopy(bomBytes, 0, fullContent, 0, bomBytes.length);
        System.arraycopy(content, 0, fullContent, bomBytes.length, content.length);

        try (InputStream is = new ByteArrayInputStream(fullContent);
             InputStreamReader reader = new InputStreamReader(is, StandardCharsets.UTF_8)) {

            int firstChar = reader.read();
            if (firstChar == 0xFEFF) {
                System.out.println("Detected and skipped BOM");
            } else {
                System.out.println("No BOM detected, first char: " + (char)firstChar);
            }

            // 继续读取剩余内容
            int ch;
            StringBuilder sb = new StringBuilder();
            while ((ch = reader.read()) != -1) {
                sb.append((char)ch);
            }
            System.out.println("Content: " + sb.toString());
        }
    }
}
该程序演示了如何检测并跳过UTF-8 BOM。首先构建包含EF BB BF前缀的字节流,然后通过InputStreamReader读取第一个字符。若值为0xFEFF,说明存在BOM,此时应忽略该字符并继续读取后续内容。若不处理,字符串开头将包含不可见控制字符,可能影响JSON解析或数据库存储。此方法适用于已知文件来源编码的场景。
当OutputStreamWriter写入中文出现乱码时如何定位
如果通过OutputStreamWriter写入中文后,目标文件或终端显示乱码,通常是因为Writer使用的编码与接收端期望的编码不一致。排查步骤包括:确认Writer构造时指定的Charset是否与文件保存格式匹配;检查JVM启动参数-Dfile.encoding是否被意外修改;验证写入的字节序列是否符合预期编码规范。例如,若文件需用UTF-8保存,但Writer使用了ISO-8859-1,则中文字节会被错误映射。


















