








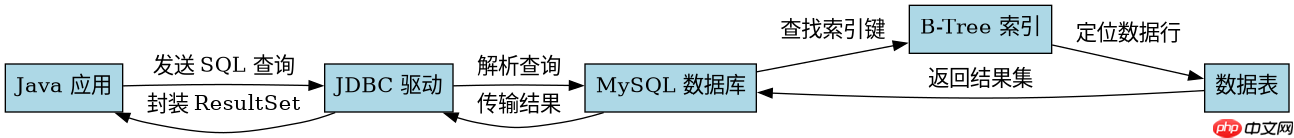
java jdbc 本身不直接处理数据库索引,而是通过构建包含正确 where 子句的 sql 语句来利用索引。开发者需要确保查询条件中的列与数据库表上的索引定义一致,并使用 preparedstatement 执行查询以避免 sql 注入并提升性能。
如何编写利用索引的 SQL 查询
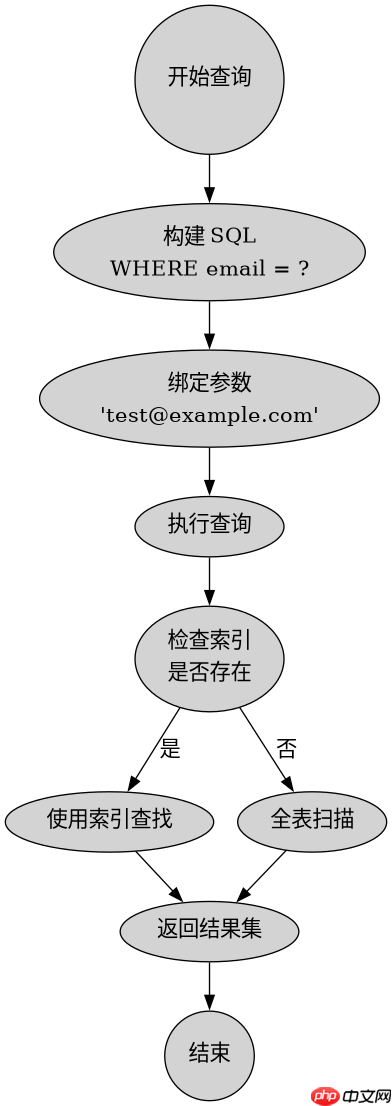
要利用索引,必须在 SQL 语句中使用 WHERE 子句指定具体的过滤条件。JDBC 驱动会将这些参数传递给数据库引擎,由引擎决定使用哪个索引。例如,如果有一张用户表 users 并在 email 列上建立了唯一索引,查询时应直接使用 WHERE email = ?。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;

public class IndexQueryExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        // 假设 users 表在 email 列上有索引
        String sql = "SELECT id, name FROM users WHERE email = ?";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            pstmt.setString(1, "test@example.com");

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    System.out.println("ID: " + rs.getInt("id") + ", Name: " + rs.getString("name"));
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
运行上述代码时,数据库会检查 users 表的索引结构。如果 email 列有索引,数据库将直接定位到对应的索引节点,而不是扫描全表。预期输出为匹配该邮箱的用户 ID 和名称。若未建立索引,数据库可能执行全表扫描,导致性能下降。
立即学习“Java免费学习笔记(深入)”;

避免导致索引失效的常见写法
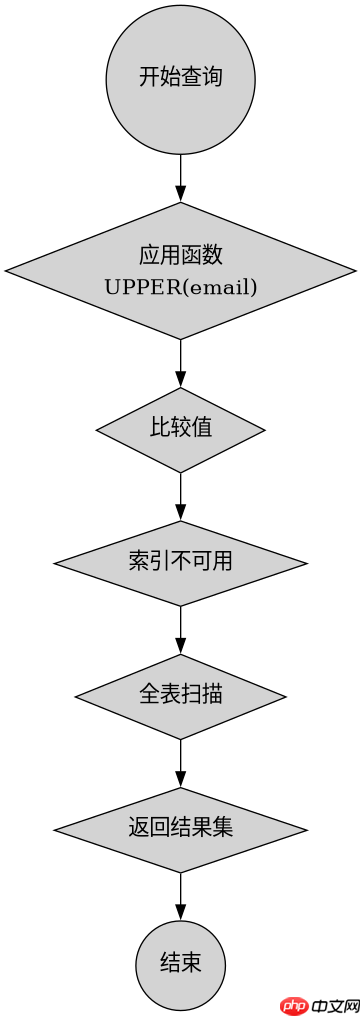
某些 SQL 写法会导致数据库忽略索引,即使列上有索引也无法加速查询。常见的包括对索引列使用函数、类型隐式转换或前导通配符。例如,使用 UPPER(email) = ? 或 email LIKE '%@example.com' 会使索引失效。应改为在应用层预处理数据或使用支持函数索引的数据库特性。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;

public class BadIndexUsageExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        // 错误示例:对索引列使用函数
        String badSql = "SELECT id, name FROM users WHERE UPPER(email) = ?";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(badSql)) {

            pstmt.setString(1, "TEST@EXAMPLE.COM");

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    System.out.println("Bad Query Result: " + rs.getString("name"));
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
此代码中,尽管 email 列有索引,但 UPPER() 函数阻止了索引的使用。数据库必须计算每一行的 UPPER(email) 值进行比较,导致全表扫描。预期输出仍为用户名称,但查询时间显著增加。应避免此类写法,改为传入小写邮箱并直接使用 WHERE email = ?。
当查询返回大量数据时如何处理
即使使用了索引,如果查询结果集非常大,JDBC 默认会尝试将所有结果加载到内存中。这可能导致内存溢出或响应缓慢。可以通过设置 Statement 或 PreparedStatement 的 fetchSize 属性来控制每次从数据库获取的行数,实现流式处理。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;

public class LargeResultSetExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        String sql = "SELECT id, name FROM users WHERE status = ?";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql, ResultSet.TYPE_FORWARD_ONLY, ResultSet.CONCUR_READ_ONLY)) {

            pstmt.setFetchSize(100); // 每次获取100行
            pstmt.setString(1, "active");

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    System.out.println("Processing: " + rs.getString("name"));
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}在此示例中,setFetchSize(100) 告诉 JDBC 驱动每次只从数据库拉取 100 行数据,而不是一次性加载所有匹配记录。这适用于索引查询返回数万条记录的场景。预期输出为逐行打印用户名称,内存占用保持低位。注意,并非所有数据库驱动都完全支持 fetchSize,需查阅具体驱动文档确认其行为。


















