








使用 fetch 获取 cbor 数据时,核心做法是调用 response.arraybuffer() 读取原始二进制流,随后利用第三方库(如 cbor-x)将其解码为 javascript 对象。由于 fetch api 默认不处理 cbor 格式,必须手动干预响应体解析过程,确保将 buffer 转换为正确的数据结构。

如何配置 fetch 请求以获取 ArrayBuffer
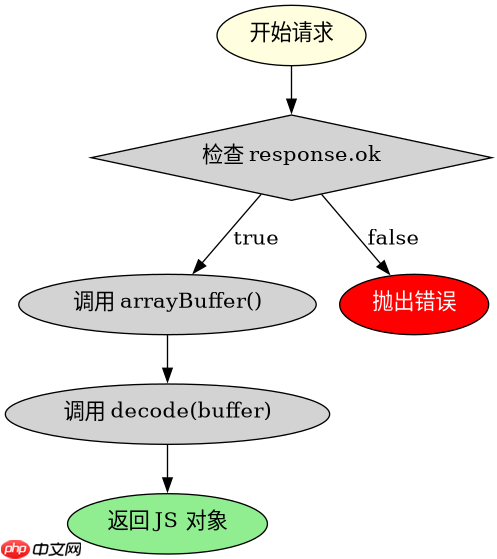
通过 fetch 发起请求后,直接调用 response.arrayBuffer() 即可获取底层二进制数据。这一步骤绕过了默认的文本或 JSON 解析器,防止数据损坏。获取到 Buffer 后,需传入解码函数进行转换。
import { decode } from 'cbor-x';

async function fetchCborData(url) {
  const response = await fetch(url);
  if (!response.ok) {
    throw new Error(`HTTP error! status: ${response.status}`);
  }

  // 获取原始二进制数据
  const buffer = await response.arrayBuffer();

  // 解码 CBOR 数据
  const data = decode(buffer);
  return data;
}

// 示例调用
fetchCborData('https://api.example.com/data.cbor')
  .then(console.log);
上述代码展示了完整的请求流程。首先检查响应状态,确保请求成功。接着通过 arrayBuffer() 提取二进制内容。最后使用 cbor-x 的 decode 方法将 Buffer 转换为 JS 对象。若接口返回的是数组或嵌套对象,解码后的结果将保持原有结构。
立即学习“Java免费学习笔记(深入)”;

如何处理 CBOR 中的特殊类型映射
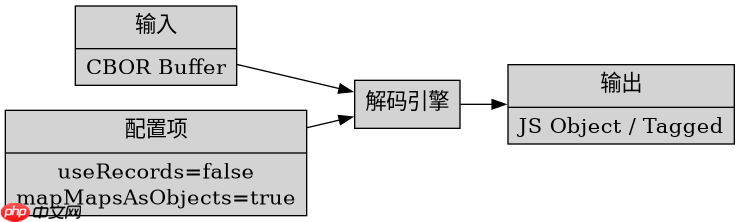
CBOR 支持多种数据类型,如字节串、大整数和标签化数据。在解码过程中,这些类型会被映射为 JavaScript 对应的原生类型或特定对象。例如,字节串通常转为 Uint8Array,而某些标签可能被保留为自定义类实例。开发者需根据实际业务逻辑处理这些映射结果,必要时进行类型检查或转换。
import { decode, Tagged } from 'cbor-x';

function processSpecialTypes(cborBuffer) {
  const decoded = decode(cborBuffer, {
    useRecords: false, // 禁用记录模式,转为普通对象
    mapMapsAsObjects: true // 将 Map 转为对象
  });

  // 检查是否包含特殊标签
  if (decoded instanceof Tagged) {
    console.log('Detected tagged value:', decoded.tag, decoded.value);
  }

  return decoded;
}

// 假设 cborData 是从 fetch 获取的 ArrayBuffer
const result = processSpecialTypes(cborData);
此段代码演示了如何在解码时配置选项以控制类型映射行为。通过设置 useRecords 和 mapMapsAsObjects,可以调整输出结构以适应前端需求。同时,检测 Tagged 实例有助于识别未明确定义的特殊数据块。这种处理方式确保了复杂 CBOR 数据能被正确解析和利用。
当 CBOR 数据包含空值或缺失字段时会发生什么
如果 CBOR 编码的数据中包含空值(null)或缺失字段,解码后的 JavaScript 对象会相应地表现为 null 属性或完全缺少该键。这取决于编码器在序列化时的具体实现。对于缺失字段,访问时将返回 undefined;对于显式 null 值,则返回 null。开发者应在代码中做好防御性编程,避免对可能为空的属性直接操作。

















