








java 日志性能优化的核心在于减少 i/o 阻塞和避免无效的对象创建,具体做法是启用异步 appender、使用 slf4j 的占位符机制以及通过配置级别过滤掉低优先级日志。采用 asyncappender 可以将同步写入磁盘的操作转化为向内存队列发送消息,从而大幅降低业务线程的等待时间;同时,在代码中使用 log.info("user {} created", userid) 而非字符串拼接,可以避免在日志级别被禁用时产生无用的字符串连接开销。

如何配置异步 Appender 以解耦日志写入与业务逻辑
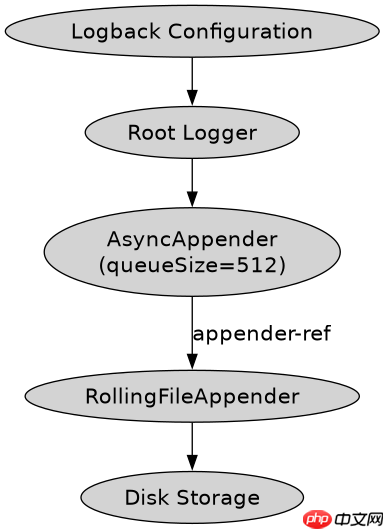
通过配置 Logback 或 Log4j2 的异步 Appender,可以将日志记录从同步阻塞模式切换为基于 Disruptor 或 LinkedBlockingQueue 的异步模式,显著降低对主线程执行时间的干扰。在 Logback 中,需要定义一个 AsyncAppender 并指定其引用的目标 Appender(如 ConsoleAppender 或 RollingFileAppender),同时设置合理的队列容量和丢弃策略,以防止在高并发场景下因队列满而丢失日志或导致应用卡顿。
<configuration>
    <appender name="ASYNC" class="ch.qos.logback.classic.AsyncAppender">
        <queueSize>512</queueSize>
        <discardingThreshold>0</discardingThreshold>
        <includeCallerData>false</includeCallerData>
        <appender-ref ref="FILE"/>
    </appender>

    <appender name="FILE" class="ch.qos.logback.core.rolling.RollingFileAppender">
        <file>logs/app.log</file>
        <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy">
            <fileNamePattern>logs/app.%d{yyyy-MM-dd}.log</fileNamePattern>
        </rollingPolicy>
        <encoder>
            <pattern>%d{HH:mm:ss.SSS} [%thread] %-5level %logger{36} - %msg%n</pattern>
        </encoder>
    </appender>

    <root level="INFO">
        <appender-ref ref="ASYNC"/>
    </root>
</configuration>
上述配置中,queueSize 设置为 512,意味着当队列填满时,默认会丢弃 TRACE 和 DEBUG 级别的日志,除非将 discardingThreshold 设为 0 以保留所有日志。关闭 includeCallerData 可以进一步提升性能,因为获取调用者信息(文件名、行号)涉及栈追踪解析,开销较大。业务代码只需正常调用 logger 接口,底层由后台线程负责将日志事件从队列取出并写入文件,主线程几乎不受 I/O 影响。
立即学习“Java免费学习笔记(深入)”;

为什么使用占位符比字符串拼接更高效
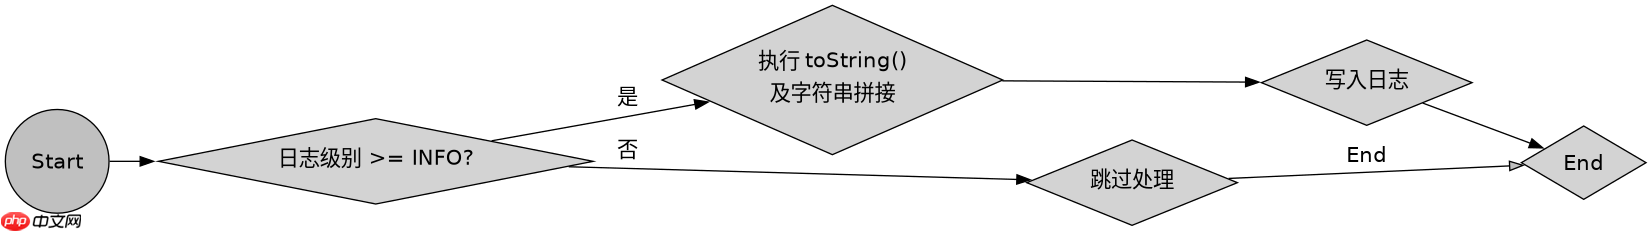
在使用 SLF4J 等日志门面时,使用占位符 {} 能够避免在日志级别不符合输出条件时进行昂贵的字符串拼接操作。如果直接使用 + 或 String.format,即使当前日志级别为 WARN 而代码调用的是 INFO,JVM 仍然会先执行字符串拼接生成最终字符串,然后再传递给 Logger 进行判断,这会导致不必要的 CPU 周期消耗和内存分配。占位符机制允许 Logger 在打印前检查参数对象是否实际需要被格式化,从而跳过耗时操作。
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;

public class LogPerformanceExample {
    private static final Logger logger = LoggerFactory.getLogger(LogPerformanceExample.class);

    public void processUser(String userId, UserProfile profile) {
        // 低效写法:无论日志级别如何,都会执行 toString() 和字符串拼接
        // logger.info("Processing user: " + userId + " with details: " + profile.toString());

        // 高效写法:仅在 INFO 级别启用时,才调用 profile.toString()
        logger.info("Processing user: {} with details: {}", userId, profile);
    }

    static class UserProfile {
        @Override
        public String toString() {
            System.out.println("Expensive toString called!");
            return "UserProfile{id=1, name='Test'}";
        }
    }
}

// 预期结果:
// 当日志级别设置为 WARN 时,控制台不会输出 "Expensive toString called!"
// 当日志级别设置为 INFO 时,控制台会输出日志且打印 "Expensive toString called!"
在上面的代码中,processUser 方法展示了两种写法的差异。当日志框架配置为只输出 WARN 及以上级别时,高效写法中的 profile.toString() 根本不会被执行,因为 SLF4J 会在内部检查日志级别,只有当级别匹配时才会触发参数的转换和拼接。这种机制在处理复杂对象或包含大量数据的日志内容时,能显著减少 GC 压力和 CPU 负载。此外,确保日志实现类(如 Logback)与门面类(SLF4J)版本兼容,也能避免额外的桥接开销。
异步队列满时日志数据是否会丢失及如何处理
当异步 Appender 的内存队列已满时,默认行为取决于 discardingThreshold 的配置,若未特别设置,Logback 会丢弃 TRACE 和 DEBUG 级别的日志以保护主线程性能。为了防止重要业务日志丢失,开发者应调整队列大小或修改丢弃阈值,甚至自定义 DiscardPolicy。在生产环境中,通常建议将队列容量设置为足以应对峰值流量的值,并将 discardingThreshold 设为 0,但这会增加内存占用和潜在的 OOM 风险,需根据实际监控数据进行权衡。



















