








定位gc问题根因的核心在于通过日志中的时间戳、触发原因和内存变化数据,将异常现象与具体的垃圾回收器行为对应起来。具体做法是结合jvm启动参数开启详细日志,使用g1或zgc等现代收集器时配合gclogviewer等工具解析,重点排查full gc的频繁触发原因(如元空间溢出或老年代不足)以及young gc耗时过长导致的stw停顿。通过分析survivor区利用率、晋升失败和分配担保等关键指标,可以明确是内存泄漏还是堆大小配置不当。

如何开启并获取详细的GC日志信息
要分析GC问题,第一步是确保JVM输出足够详细的日志。在Java 9之前,通常使用-XX:+PrintGCDetails、-XX:+PrintGCDateStamps和-Xloggc:路径来生成日志文件。从Java 10开始,推荐使用统一的-Xlog:gc*标签机制,例如-Xlog:gc*:file=gc.log:time,uptime,level,tags,这样可以更灵活地控制输出内容。开启这些参数后,JVM会在每次发生Minor GC、Major GC或Full GC时记录详细信息,包括回收前后的内存分布、耗时以及使用的算法。
import java.util.ArrayList;
import java.util.List;

public class GcTest {
    public static void main(String[] args) {
        // 模拟内存分配,触发GC
        List<byte[]> list = new ArrayList<>();
        for (int i = 0; i < 1000000; i++) {
            list.add(new byte[1024 * 10]); // 10KB
            if (i % 100000 == 0) {
                System.out.println("Allocated " + i + " items");
            }
        }
        // 强制触发Full GC以观察日志
        System.gc();
    }
}
上述代码通过不断分配大对象并保留引用,最终调用System.gc()触发Full GC。运行该程序时,配合-Xlog:gc*:file=gc.log:time,uptime,level,tags参数,可以在gc.log中看到类似以下的条目:[2023-10-27T10:00:00.000+0800][1.234s][info][gc] Full GC (System.gc()) 256M->50M(512M),这直接展示了Full GC前后的堆内存变化和总耗时。开发者应重点关注“->”前后的数值差值,判断回收效率,以及耗时是否超过应用容忍阈值。
立即学习“Java免费学习笔记(深入)”;

如何通过日志区分Young GC与Full GC的影响
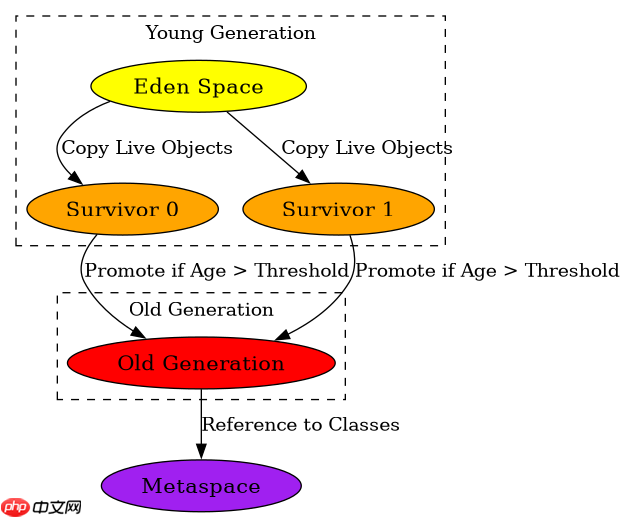
在获取日志后,需要区分不同GC类型对系统性能的影响。Young GC主要发生在Eden区和Survivor区之间,通常耗时极短,对应用影响较小。而Full GC涉及整个堆内存(包括老年代),耗时较长,可能导致应用暂停(STW)。通过分析日志中的标记,可以快速识别这两类事件。例如,在G1收集器的日志中,Young GC通常标记为“Pause Young (Normal)”,而Full GC则标记为“Pause Full”。此外,日志还会显示触发原因,如“Ergonomics”表示由JVM自动调整触发,“Metadata Threshold”表示元空间不足触发。

// 假设这是从GC日志中提取的关键数据结构示例
// 实际分析中,我们关注的是日志文本的解析
public class GcLogEntry {
    String timestamp;
    String type; // "Young GC" or "Full GC"
    long beforeHeap;
    long afterHeap;
    double durationMs;
    String cause; // "Ergonomics", "System.gc()", etc.
}

// 模拟解析逻辑
public void analyzeLog(String logLine) {
    if (logLine.contains("Full GC")) {
        // 处理Full GC逻辑
        System.out.println("Detected Full GC, check for memory leaks");
    } else if (logLine.contains("Pause Young")) {
        // 处理Young GC逻辑
        System.out.println("Detected Young GC, normal operation");
    }
}
通过上述模拟解析逻辑,开发者可以编写脚本自动化分析日志。在实际操作中,如果发现Young GC频率过高但单次耗时正常,可能意味着对象生命周期短,适合调整新生代大小。如果Full GC频繁且回收效果不佳(即afterHeap接近beforeHeap),则可能存在内存泄漏或老年代空间不足。例如,若日志显示“Tenuring Distribution”中所有对象都直接晋升到老年代,说明Survivor区太小或对象年龄判定有问题,此时应调整-XX:MaxTenuringThreshold参数。
当出现频繁Full GC时如何定位内存泄漏
频繁Full GC通常是内存问题的信号。定位根因的第一步是检查Full GC后的堆内存是否显著下降。如果下降不明显,说明大部分对象仍然存活,可能存在内存泄漏。此时,可以结合堆转储文件(Heap Dump)进行分析。在GC日志中,如果看到“Metadata Threshold”或“Allocation Failure”作为触发原因,分别指向元空间溢出和老年代分配失败。对于元空间溢出,需检查动态加载的类是否过多;对于老年代分配失败,需检查大对象或长期存活的对象是否未被回收。
具体做法是,在发现频繁Full GC时,设置-XX:+HeapDumpOnOutOfMemoryError参数,让JVM在OOM时自动生成堆转储文件。然后使用MAT(Memory Analyzer Tool)或JProfiler打开该文件,查看Dominators树,找出占用内存最大的对象及其GC Roots引用链。例如,如果发现大量String对象被某个静态集合持有,且该集合从未清理,即可确认为内存泄漏点。此外,还可以分析日志中的“Promotion Failed”信息,如果频繁出现,说明老年代空间不足以容纳从新生代晋升的对象,可能需要增大-XX:MaxMetaspaceSize或调整堆结构。


















