








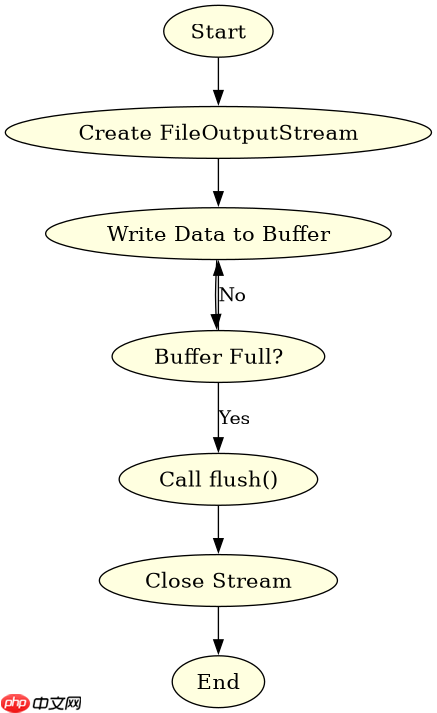
在 java 的 fileoutputstream 中,flush() 方法用于强制将缓冲区中的数据立即写入文件。默认情况下,fileoutputstream 是带缓冲的(内部使用 bufferedoutputstream),数据会先存入内存缓冲区,当缓冲区满或流关闭时才会自动刷盘。调用 flush() 可以确保数据实时持久化到磁盘,避免程序异常退出导致数据丢失。
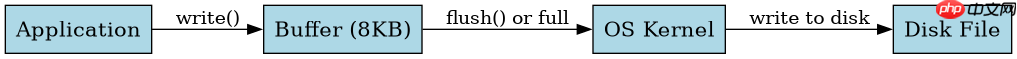
FileOutputStream 的缓冲机制是怎样的
FileOutputStream 继承自 FilterOutputStream,其底层维护了一个大小为 8192 字节的字节数组作为缓冲区。当你调用 write(int b) 或 write(byte[] b) 时,数据首先被复制到该缓冲区中。只有当缓冲区填满、显式调用 flush() 或调用 close() 时,数据才会通过系统调用写入操作系统内核的文件描述符中。
import java.io.FileOutputStream;
import java.io.IOException;

public class FlushDemo {
    public static void main(String[] args) throws IOException {
        // 创建 FileOutputStream 对象,指定输出文件
        try (FileOutputStream fos = new FileOutputStream("test.txt")) {
            String data = "Hello, World!";
            byte[] bytes = data.getBytes();

            // 写入数据到缓冲区
            fos.write(bytes);

            // 手动刷新缓冲区,确保数据写入磁盘
            fos.flush();

            System.out.println("Data flushed successfully.");
        }
    }
}运行上述代码后,test.txt 文件中会立即包含 "Hello, World!" 内容。如果不调用 flush(),在 try-with-resources 块结束前,数据可能仍停留在内存缓冲区中。如果程序在此时崩溃,数据将丢失。
立即学习“Java免费学习笔记(深入)”;

什么情况下必须手动调用 flush()
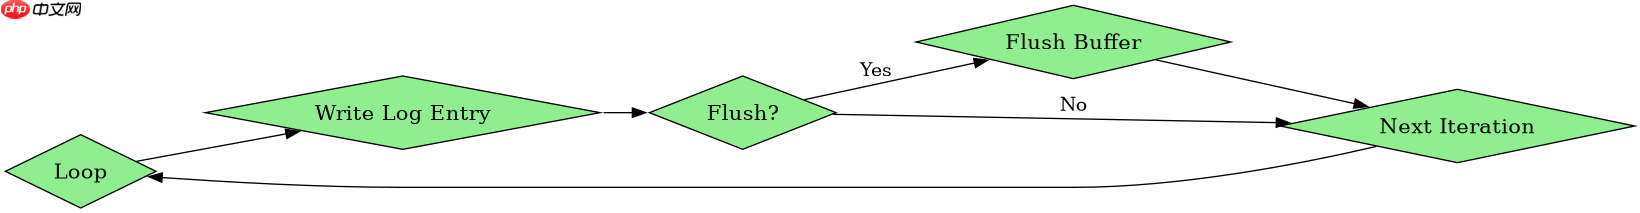
在以下场景中,必须手动调用 flush():一是需要实时查看日志或监控数据时;二是进行长连接或大数据量传输时,需分批次提交数据;三是某些特殊业务逻辑要求数据即时落盘。若不调用 flush(),数据将滞留在缓冲区,直到缓冲区满或流关闭。
import java.io.FileOutputStream;
import java.io.IOException;

public class RealTimeFlushDemo {
    public static void main(String[] args) throws IOException {
        try (FileOutputStream fos = new FileOutputStream("realtime.log")) {
            for (int i = 0; i < 5; i++) {
                String logEntry = "Log entry " + i + "\n";
                fos.write(logEntry.getBytes());
                // 每写入一条日志就刷新,确保实时可见
                fos.flush();
            }
        }
    }
}
此示例中,每次循环都调用 flush(),确保每条日志立即写入文件。这在日志记录、实时监控等场景中非常有用。注意,频繁调用 flush() 会增加 I/O 开销,影响性能,因此应根据实际需求权衡。
不关闭流直接调用 flush() 会有什么后果
如果在未关闭流的情况下多次调用 flush(),数据会被重复写入吗?不会。flush() 只是将缓冲区中尚未写入的数据推送到文件描述符,它不会重置缓冲区或重新写入已发送的数据。但需要注意的是,如果流未正确关闭,可能导致资源泄漏或数据不完整。最佳实践是在 finally 块或使用 try-with-resources 确保流被正确关闭,从而隐式触发最终的 flush() 和系统资源释放。



















