








java jdbc 实现批量操作的数据权限控制,核心在于利用 connection 的自动提交(auto-commit)机制配合事务边界管理。具体做法是调用 connection.setautocommit(false) 关闭自动提交,随后通过 addbatch() 和 executebatch() 执行批量 sql,并在 finally 块中根据执行结果决定调用 commit() 还是 rollback()。这种模式确保了要么所有数据变更生效,要么全部回滚,从而在逻辑上维护了数据的完整性和一致性。

JDBC 事务与批处理的标准流程是怎样的
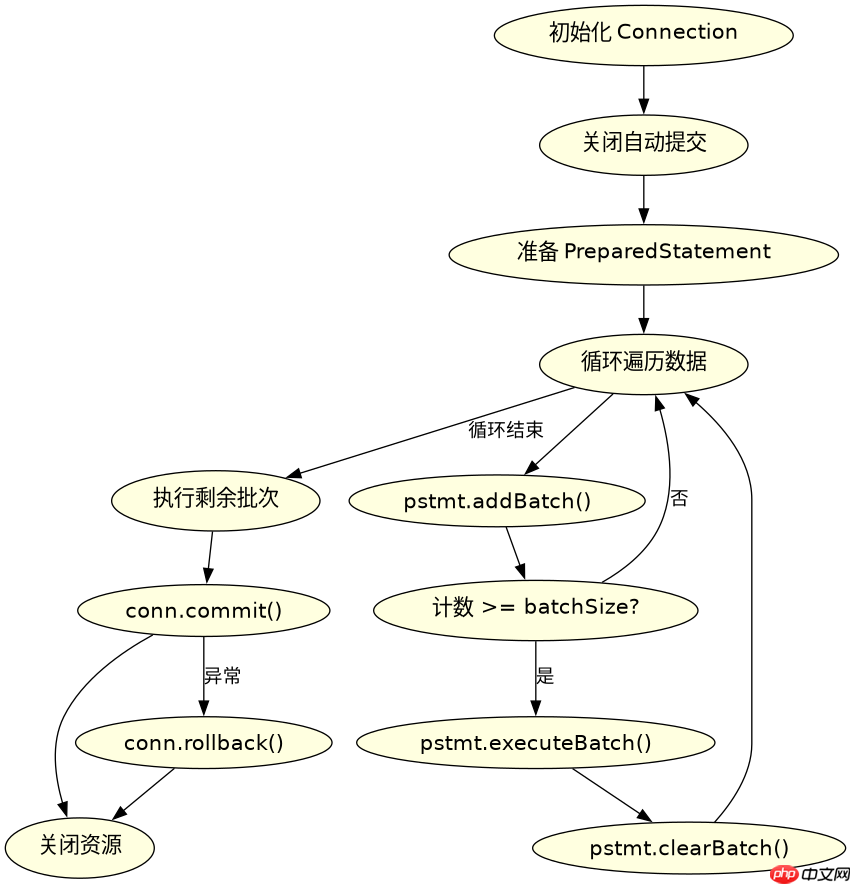
JDBC 事务管理的标准流程依赖于连接对象的状态切换。开发者需要显式地获取数据库连接,将其从自动提交模式切换到手动管理模式,然后构建批量任务,最后通过异常捕获机制来保证事务的原子性。这一过程不涉及复杂的框架配置,而是基于原生 API 的顺序调用。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class BatchTransactionExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        // 模拟批量数据
        String[] names = {"Alice", "Bob", "Charlie"};
        int[] ages = {25, 30, 35};

        Connection conn = null;
        try {
            // 1. 建立连接
            conn = DriverManager.getConnection(url, user, password);

            // 2. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            // 3. 准备语句
            String sql = "INSERT INTO users (name, age) VALUES (?, ?)";
            PreparedStatement pstmt = conn.prepareStatement(sql);

            // 4. 添加批量项
            for (int i = 0; i < names.length; i++) {
                pstmt.setString(1, names[i]);
                pstmt.setInt(2, ages[i]);
                pstmt.addBatch();
            }

            // 5. 执行批量操作
            pstmt.executeBatch();

            // 6. 提交事务
            conn.commit();
            System.out.println("批量插入成功");

            // 清理资源
            pstmt.close();

        } catch (SQLException e) {
            // 7. 发生异常则回滚
            if (conn != null) {
                try {
                    conn.rollback();
                    System.err.println("事务回滚: " + e.getMessage());
                } catch (SQLException ex) {
                    ex.printStackTrace();
                }
            }
            e.printStackTrace();
        } finally {
            // 8. 关闭连接
            if (conn != null) {
                try {
                    conn.close();
                } catch (SQLException e) {
                    e.printStackTrace();n                }
            }
        }
    }
}
上述代码展示了完整的生命周期。首先通过 DriverManager.getConnection 获取连接,默认情况下该连接的 getAutoCommit() 返回 true。调用 setAutoCommit(false) 后,后续的 SQL 语句不会立即持久化到数据库。当 executeBatch() 执行完毕后,如果没有抛出异常,程序进入 commit() 阶段,此时数据才真正写入磁盘。如果中间任何一步出现 SQLException,例如主键冲突或网络中断,控制流跳转至 catch 块,执行 rollback() 撤销自事务开始以来的所有更改。最后 finally 块确保连接被释放,防止连接泄漏。
立即学习“Java免费学习笔记(深入)”;

如何优化大批量数据的性能与内存占用
在处理大规模数据时,默认的 JDBC 批处理可能会因为数据包过大或驱动实现差异导致性能瓶颈。优化策略主要包括设置 rewriteBatchedStatements 参数、调整 batchSize 以及使用 Statement.RETURN_GENERATED_KEYS 等特性。这些配置直接影响驱动程序如何将 SQL 打包发送给数据库服务器。

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class OptimizedBatchExample {
    public static void main(String[] args) {
        // URL 中包含优化参数
        String url = "jdbc:mysql://localhost:3306/testdb?rewriteBatchedStatements=true&cachePrepStmts=true";
        String user = "root";
        String password = "password";

        int batchSize = 1000;
        int count = 0;

        Connection conn = null;
        try {
            conn = DriverManager.getConnection(url, user, password);
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, age) VALUES (?, ?)";
            PreparedStatement pstmt = conn.prepareStatement(sql, PreparedStatement.RETURN_GENERATED_KEYS);

            for (int i = 0; i < 10000; i++) { // 模拟 10000 条数据
                pstmt.setString(1, "User_" + i);
                pstmt.setInt(2, 20 + (i % 50));
                pstmt.addBatch();

                // 每达到 batchSize 执行一次,避免内存溢出
                if (++count % batchSize == 0) {
                    pstmt.executeBatch();
                    pstmt.clearBatch();
                }
            }

            // 执行剩余的数据
            if (count % batchSize != 0) {
                pstmt.executeBatch();
            }

            conn.commit();
            System.out.println("完成 " + count + " 条记录");

        } catch (SQLException e) {
            if (conn != null) {
                try { conn.rollback(); } catch (SQLException ex) { ex.printStackTrace(); }
            }
            e.printStackTrace();
        } finally {
            if (conn != null) {
                try { conn.close(); } catch (SQLException e) { e.printStackTrace(); }
            }
        }
    }
}
在这个优化版本中,JDBC URL 添加了 rewriteBatchedStatements=true。对于 MySQL 驱动,这会将多个 INSERT 语句合并为一条多值 INSERT 语句(如 INSERT INTO ... VALUES (...), (...)),大幅减少网络往返次数。同时,代码引入了 batchSize 计数器,每累积 1000 条数据就执行一次 executeBatch() 并调用 clearBatch()。这样做可以防止 PreparedStatement 内部缓冲区无限增长导致 OutOfMemoryError。此外,cachePrepStmts=true 启用了预编译语句缓存,避免了重复解析相同 SQL 模板的开销。最终结果是吞吐量显著提升,且内存占用保持平稳。
批量操作中遇到部分失败时如何处理
当批量操作中的某一条记录因约束冲突(如唯一索引违反)而失败时,JDBC 的行为取决于具体的数据库驱动和配置。默认情况下,大多数驱动会抛出 BatchUpdateException 并终止整个批次的后续执行。为了处理这种情况,开发者需要捕获该异常,检查 getUpdateCounts() 数组来确定哪些语句成功、哪些失败,并根据业务需求决定是跳过错误记录继续处理,还是整体回滚。
import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class PartialFailureHandling {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        String[] names = {"Valid_User", "Duplicate_User", "Another_Valid"};
        // 假设数据库中已存在 "Duplicate_User"

        Connection conn = null;
        try {
            conn = DriverManager.getConnection(url, user, password);
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name) VALUES (?)";
            PreparedStatement pstmt = conn.prepareStatement(sql);

            for (String name : names) {
                pstmt.setString(1, name);
                pstmt.addBatch();
            }

            pstmt.executeBatch();
            conn.commit();

        } catch (BatchUpdateException e) {
            // 捕获批量更新异常
            int[] updateCounts = e.getUpdateCounts();
            System.err.println("批量操作部分失败,状态数组: ");
            for (int i = 0; i < updateCounts.length; i++) {
                if (updateCounts[i] == Statement.SUCCESS_NO_INFO ||
                    updateCounts[i] == Statement.EXECUTE_FAILED) {
                    System.err.println("第 " + (i+1) + " 条记录失败");
                } else {
                    System.out.println("第 " + (i+1) + " 条记录成功,影响行数: " + updateCounts[i]);
                }
            }

            // 根据策略决定是否回滚
            // 如果业务要求严格一致,则回滚
            try { conn.rollback(); } catch (SQLException ex) { ex.printStackTrace(); }

        } catch (SQLException e) {
            e.printStackTrace();
        } finally {
            if (conn != null) {
                try { conn.close(); } catch (SQLException e) { e.printStackTrace(); }
            }
        }
    }
}
当执行包含重复数据的批量插入时,数据库会在第二条记录处报错。JDBC 驱动抛出 BatchUpdateException 而非普通的 SQLException。通过调用异常的 getUpdateCounts() 方法,可以获得一个整型数组,其中每个元素对应批次中相应语句的执行结果。如果值为 Statement.SUCCESS_NO_INFO 或 Statement.EXECUTE_FAILED,表示该条记录未成功插入。在实际生产中,可以根据这个数组筛选出成功的记录进行日志记录,或者根据业务规则选择忽略错误记录并尝试提交已成功的事务(这需要更复杂的分片逻辑),或者像示例中那样直接回滚以保证数据强一致性。



















