








使用 java 8 引入的 stream api 配合 collectors.groupingby 和 collectors.counting 是最简洁且高效的统计方式。通过调用 list.stream().collect(...),可以将 list 中的元素按值分组并自动计算每组的数量,最终返回一个 map

如何自定义比较器处理复杂对象
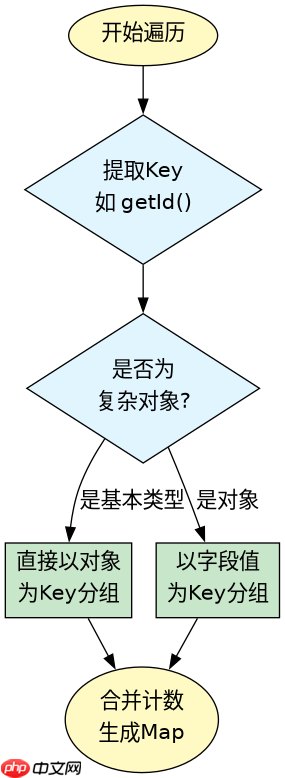
当 List 中存储的是自定义对象或需要基于对象的特定字段进行统计时,groupingBy 收集器的第一个参数可以传入一个 Classifier 函数。这个函数决定了分组的依据,例如提取对象的 ID 或名称作为 Key,从而实现对复杂结构的精准计数。

import java.util.*;
import java.util.stream.Collectors;

public class ComplexCount {
    public static void main(String[] args) {
        List<User> users = Arrays.asList(
            new User(1, "Alice"),
            new User(2, "Bob"),
            new User(1, "Alice") // 重复ID
        );

        // 按用户ID统计出现次数
        Map<Integer, Long> countById = users.stream()
            .collect(Collectors.groupingBy(
                User::getId,
                Collectors.counting()
            ));

        System.out.println(countById); // {1=2, 2=1}
    }

    static class User {
        int id;
        String name;
        User(int id, String name) { this.id = id; this.name = name; }
        public Integer getId() { return id; }
    }
}
如何处理空值或null元素
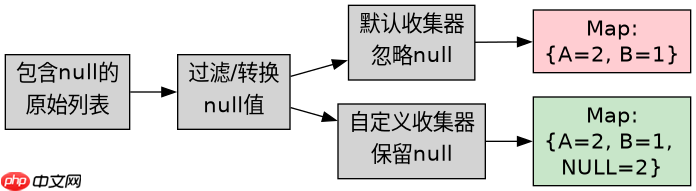
Stream API 默认会跳过 null 元素,如果列表中可能包含 null 且需要统计其出现次数,必须显式指定 groupingBy 的第二个参数为 HashMap::new 以确保保留 null 键,或者在流处理前过滤掉 null。若未做特殊处理,null 将不会出现在最终的统计 Map 中。
立即学习“Java免费学习笔记(深入)”;
import java.util.*;
import java.util.stream.Collectors;

public class NullHandling {
    public static void main(String[] args) {
        List<String> list = Arrays.asList("A", null, "B", null, "A");

        // 默认行为:null被忽略
        Map<String, Long> defaultMap = list.stream()
            .collect(Collectors.groupingBy(s -> s, Collectors.counting()));
        System.out.println(defaultMap); // {A=2, B=1} - 无null

        // 显式保留null:使用HashMap工厂方法
        Map<String, Long> withNullMap = list.stream()
            .collect(Collectors.groupingBy(
                s -> s == null ? "NULL_PLACEHOLDER" : s,
                HashMap::new,
                Collectors.counting()
            ));
        System.out.println(withNullMap); // {A=2, B=1, NULL_PLACEHOLDER=2}
    }
} 

















