








java jdbc 实现批量操作超时,核心是设置 statement 的 setquerytimeout() 属性。调用该方法后,jdbc 驱动会在执行 executebatch() 时监控耗时,一旦超过设定秒数,就会抛出 sqlexception。需要注意的是,并非所有数据库驱动都支持此功能,且该超时仅针对 sql 语句的执行时间,不包含网络传输或驱动内部处理的时间。

setQueryTimeout() 对 executeBatch() 的影响范围是什么
该设置作用于当前 Statement 对象的生命周期内,直到被再次修改或关闭。当执行 executeBatch() 时,驱动程序会逐个或分批执行 SQL 语句。如果某条语句的执行时间超过了设定的阈值,驱动会立即中断后续操作并抛出异常。这意味着批量操作具有原子性的中断特征:要么全部成功,要么在失败点停止,已执行的语句是否回滚取决于事务隔离级别和自动提交状态。
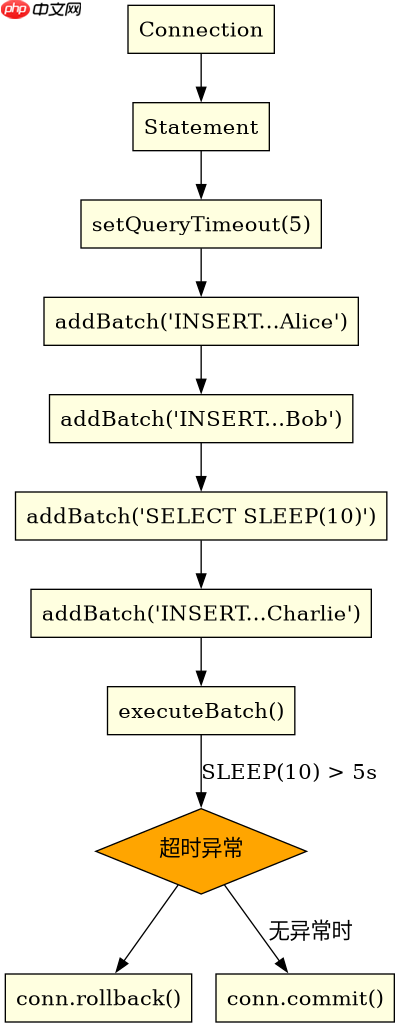
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.sql.Statement;

public class BatchTimeoutExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement()) {

            // 设置查询超时时间为 5 秒
            stmt.setQueryTimeout(5);

            // 添加批量 SQL
            stmt.addBatch("INSERT INTO users (name) VALUES ('Alice')");
            stmt.addBatch("INSERT INTO users (name) VALUES ('Bob')");
            // 模拟一条慢查询
            stmt.addBatch("SELECT SLEEP(10)");
            stmt.addBatch("INSERT INTO users (name) VALUES ('Charlie')");

            try {
                int[] results = stmt.executeBatch();
                System.out.println("Batch executed successfully");
            } catch (SQLException e) {
                System.err.println("Batch failed due to timeout or error: " + e.getMessage());
                // 这里通常需要根据业务逻辑决定是回滚还是继续
                if (!conn.getAutoCommit()) {
                    conn.rollback();
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
在上述代码中,stmt.setQueryTimeout(5) 设置了 5 秒的超时限制。当执行到 SLEEP(10) 这条语句时,由于执行时间超过 5 秒,executeBatch() 将抛出 SQLException。此时,Alice 和 Bob 可能已经插入成功(取决于驱动和事务配置),而 Charlie 不会被插入。开发者需要在 catch 块中处理异常,并根据需要调用 conn.rollback() 来保证数据一致性。
立即学习“Java免费学习笔记(深入)”;

不同 JDBC 驱动对超时的行为差异有哪些
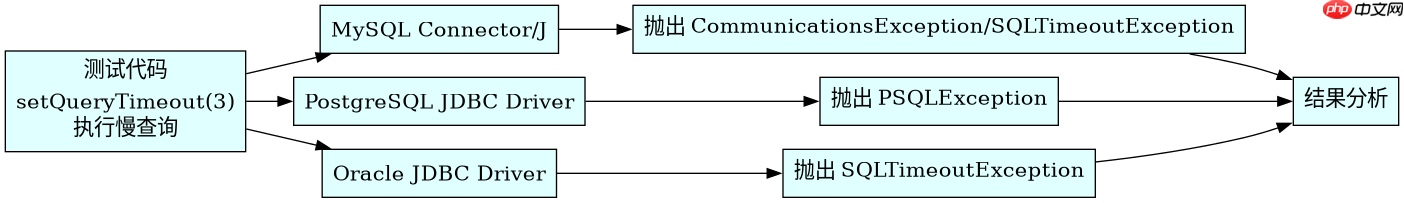
MySQL Connector/J 和 PostgreSQL JDBC Driver 对 setQueryTimeout() 的支持方式有所不同。MySQL 驱动通常在客户端发起请求后启动计时器,如果服务器端执行时间过长,驱动会检测到连接超时或主动取消请求。PostgreSQL 驱动则可能依赖于服务器的 statement_timeout 参数,或者在客户端进行轮询检查。Oracle JDBC 驱动也支持 setQueryTimeout(),但其底层实现可能涉及更复杂的线程管理和中断机制。因此,在实际项目中,建议针对不同数据库驱动进行测试,确认超时行为是否符合预期。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.sql.Statement;

public class DriverComparisonExample {
    public static void main(String[] args) {
        // MySQL 示例
        testMySQL();
        // PostgreSQL 示例
        testPostgreSQL();
    }

    private static void testMySQL() {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement()) {

            stmt.setQueryTimeout(3);
            stmt.addBatch("INSERT INTO users (name) VALUES ('TestUser')");
            stmt.addBatch("SELECT SLEEP(5)");

            try {
                stmt.executeBatch();
            } catch (SQLException e) {
                System.out.println("MySQL Timeout Exception: " + e.getMessage());
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    private static void testPostgreSQL() {
        String url = "jdbc:postgresql://localhost:5432/test";
        String user = "postgres";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement()) {

            stmt.setQueryTimeout(3);
            stmt.addBatch("INSERT INTO users (name) VALUES ('TestUser')");
            stmt.addBatch("SELECT pg_sleep(5)");

            try {
                stmt.executeBatch();
            } catch (SQLException e) {
                System.out.println("PostgreSQL Timeout Exception: " + e.getMessage());
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
通过对比测试可以发现,MySQL 驱动在超时后会抛出 CommunicationsException 或 SQLTimeoutException,而 PostgreSQL 驱动可能会抛出 PSQLException。开发者需要根据具体的异常类型来处理超时情况,并确保在不同数据库环境下都能正确捕获和处理超时异常。
如何验证批量操作超时后的数据一致性
在批量操作因超时而中断后,验证数据一致性的关键在于检查事务的状态。如果使用了手动事务管理(即 conn.setAutoCommit(false)),那么在捕获到超时异常后,应调用 conn.rollback() 来撤销所有已执行的语句。如果使用的是自动提交模式,那么已成功执行的语句将永久生效,而未执行的语句将被跳过。为了确保数据一致性,建议在批量操作中显式使用事务,并在异常处理中进行回滚操作。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.sql.Statement;

public class DataConsistencyCheckExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false); // 启用手动事务

            try (Statement stmt = conn.createStatement()) {
                stmt.setQueryTimeout(5);

                stmt.addBatch("INSERT INTO users (name) VALUES ('User1')");
                stmt.addBatch("INSERT INTO users (name) VALUES ('User2')");
                stmt.addBatch("SELECT SLEEP(10)"); // 模拟超时
                stmt.addBatch("INSERT INTO users (name) VALUES ('User3')");

                try {
                    stmt.executeBatch();
                    conn.commit(); // 提交事务
                    System.out.println("Transaction committed successfully");
                } catch (SQLException e) {
                    conn.rollback(); // 回滚事务
                    System.err.println("Transaction rolled back due to error: " + e.getMessage());
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
在该示例中,conn.setAutoCommit(false) 启用了手动事务管理。当 executeBatch() 因超时而抛出异常时,conn.rollback() 会被调用,从而撤销所有已执行的插入操作。这样可以确保在发生超时时,数据库中的数据保持一致,不会出现部分更新的情况。开发者应根据实际业务需求,合理选择事务管理策略,并在异常处理中进行相应的回滚操作。



















