








自动化分析gc日志的核心在于使用正则表达式或专用解析库提取关键指标,并输出结构化数据以便监控。具体做法是编写脚本读取日志文件,匹配停顿时间、堆内存变化等字段,将结果汇总为csv或json格式。若日志包含异常full gc,需标记触发原因如内存溢出或元空间不足。

如何提取单次GC的停顿时间与堆内存变化
通过正则表达式捕获Young GC和Old GC的关键数值,可以计算每次回收前后的堆内存差值及耗时。主要关注`[GC (Allocation Failure)`后的毫秒数以及`par old gen`等分代区域的容量变化。利用Python的`re`模块逐行扫描日志,提取时间戳、类型、耗时和内存数据,存入列表供后续统计。
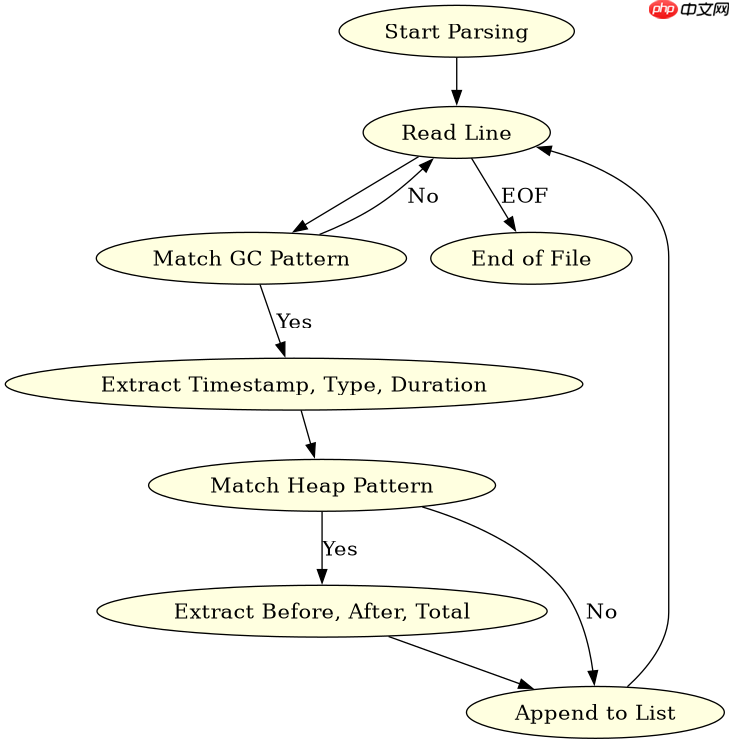
import re
import json

def parse_gc_log(log_file):
    gc_pattern = re.compile(r'\[(.*?): \[(.*?),.*?\] .*?: ([0-9.]+) ms,')
    heap_pattern = re.compile(r'.*?: ([0-9.]+) -> ([0-9.]+) Mb, ([0-9.]+) Mb)')

    results = []
    with open(log_file, 'r') as f:
        for line in f:
            gc_match = gc_pattern.search(line)
            if gc_match:
                timestamp = gc_match.group(1)
                gc_type = gc_match.group(2)
                duration = float(gc_match.group(3))

                heap_match = heap_pattern.search(line)
                if heap_match:
                    before = float(heap_match.group(1))
                    after = float(heap_match.group(2))
                    total = float(heap_match.group(3))

                    results.append({
                        "timestamp": timestamp,
                        "type": gc_type,
                        "duration_ms": duration,
                        "heap_before_mb": before,
                        "heap_after_mb": after,
                        "total_heap_mb": total
                    })
    return results

# 假设日志文件名为 gc.log
# data = parse_gc_log("gc.log")
# print(json.dumps(data[:5], indent=2))
运行上述代码后,预期输出为一个包含多个字典的列表,每个字典代表一次GC事件。例如第一次输出可能显示Young GC耗时2.5ms,堆内存从100Mb降至50Mb。开发者应检查返回的duration_ms是否为浮点数,heap_before_mb和heap_after_mb是否准确反映日志中的数值。若日志格式因JVM版本不同而变化,需调整正则表达式以适配新的布局,例如G1 GC的日志格式与Parallel GC略有差异。
立即学习“Java免费学习笔记(深入)”;

如何识别并标记潜在的内存泄漏风险
内存泄漏通常表现为老年代(Old Gen)内存使用率持续上升且GC后无法有效回收。通过分析连续多次Full GC后的堆内存残留量,可以判断是否存在泄漏。如果每次Full GC后剩余内存都接近最大堆容量,且总趋势向上,则极可能存在对象无法被垃圾回收的情况。结合Metaspace(元空间)的使用情况,若其持续增长也提示类加载器泄漏。
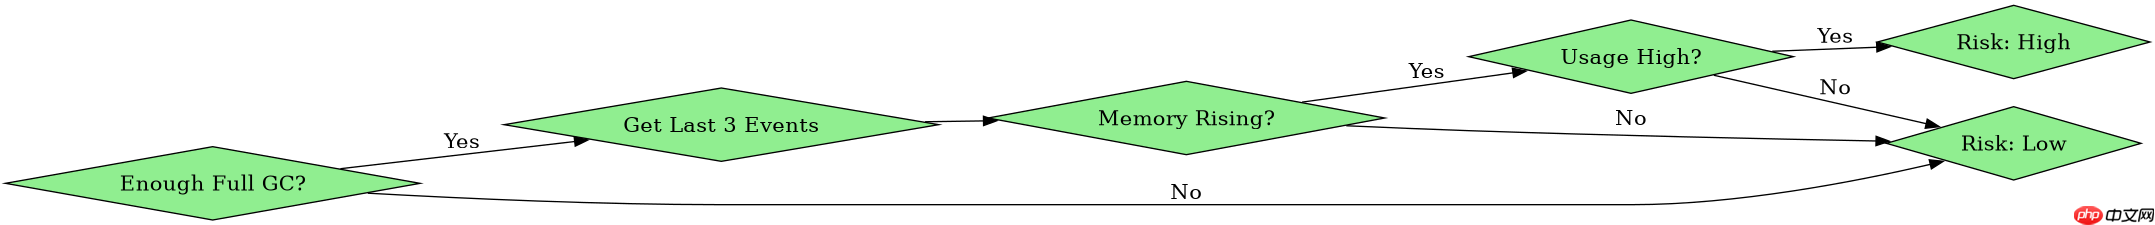
def detect_leak_risk(gc_data):
    risks = []
    old_gc_events = [e for e in gc_data if 'Full GC' in e['type']]

    if len(old_gc_events) < 3:
        return "No enough Full GC events to analyze"

    # 检查最后三次Full GC后的堆内存趋势
    recent = old_gc_events[-3:]
    heap_sizes = [e['heap_after_mb'] for e in recent]

    # 简单趋势判断:如果最近三次都高于前一次的80%且呈上升趋势
    is_rising = all(heap_sizes[i] > heap_sizes[i-1] * 0.9 for i in range(1, len(heap_sizes)))
    high_usage = all(size > 900 for size in heap_sizes) # 假设最大堆为1000Mb

    if is_rising and high_usage:
        risks.append({
            "risk_level": "High",
            "reason": "Old Gen memory usage rising and high after Full GC",
            "details": f"Last 3 Full GC remaining: {heap_sizes}"
        })
    else:
        risks.append({"risk_level": "Low", "reason": "No obvious leak pattern detected"})

    return risks

# 假设data是从parse_gc_log获取的数据
# print(detect_leak_risk(data))
该函数会返回一个风险等级评估。如果检测到老年代内存持续高位且未下降,将标记为高风险。开发者需注意,正常的业务高峰也可能导致高内存使用,因此应结合业务周期判断。此外,元空间(Metaspace)的日志通常单独记录,若发现Metaspace持续增长,需额外检查动态代理或Groovy脚本等场景。自动化分析工具应将此类警告集成到告警系统中,以便及时介入排查。
基于程序中某个输入、条件或结果的具体问题
当GC日志中出现`OutOfMemoryError: Java heap space`时,自动化分析应能直接定位到触发OOM前的最后一次GC详情。这有助于确定是堆内存瞬间不足还是长期积累导致。通过分析OOM前的堆内存快照和GC频率,可以区分是突发流量导致的临时峰值还是真正的内存泄漏。具体做法是在解析日志时,捕获包含`java.lang.OutOfMemoryError`的行,并回溯其之前的GC记录,构建一个时间窗口内的内存变化视图。



















