








升级后验证规则 regex 简化导致校验失效,通常是因为正则表达式中的锚点(如 $)被移除或转义字符丢失,导致原本严格的匹配变成了宽松的部分匹配。排查时,应重点检查正则编译前后的字符串差异,确认是否因代码重构意外去除了边界限制,从而让非法输入通过了校验。

如何对比新旧正则的匹配行为差异
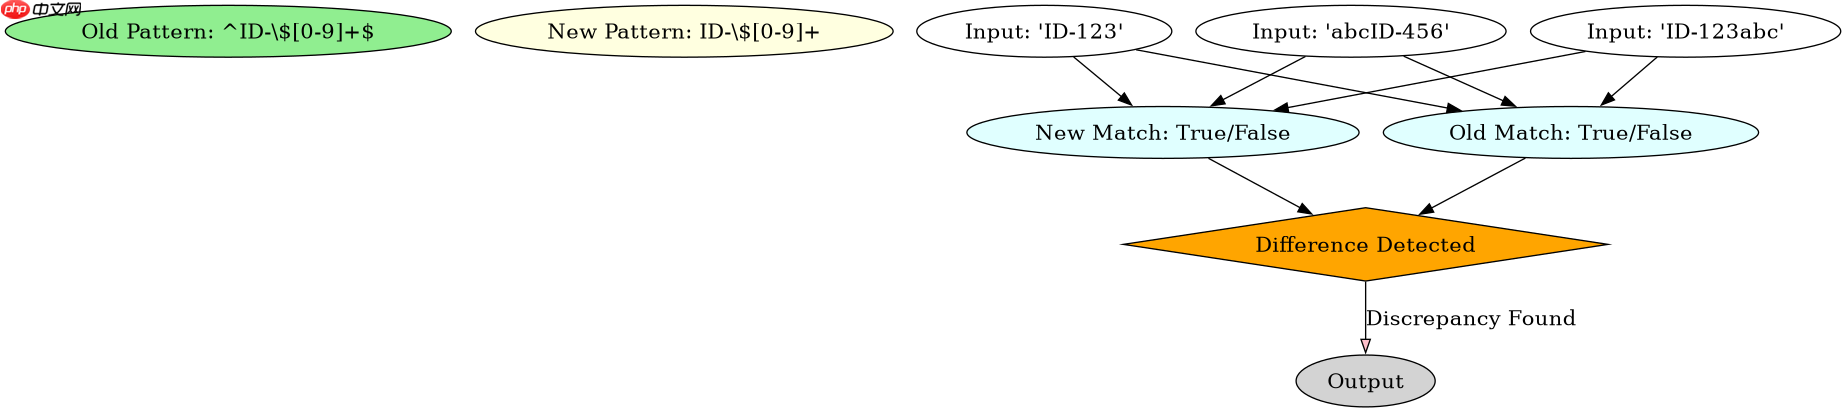
通过编写测试用例,分别使用旧版和新版的正则表达式对同一组输入进行匹配,可以直观地看到哪些输入从“不匹配”变成了“匹配”。这种差异通常源于简化过程中移除了 ^ 和 $ 等锚点,或者错误地处理了特殊字符。
import re

def check_regex(pattern, test_input):
    match = re.search(pattern, test_input)
    return bool(match)

# 假设旧版正则严格匹配以 'ID-' 开头且仅包含数字的字符串
old_pattern = r'^ID-\$[0-9]+$'
# 新版简化后可能误删了锚点,变成部分匹配
new_pattern = r'ID-\$[0-9]+'

test_cases = ['ID-123', 'ID-123abc', 'abcID-456']
for case in test_cases:
    old_res = check_regex(old_pattern, case)
    new_res = check_regex(new_pattern, case)
    if old_res != new_res:
        print(f"Input: {case}, Old: {old_res}, New: {new_res}")
为什么简化后的正则会导致非法输入通过
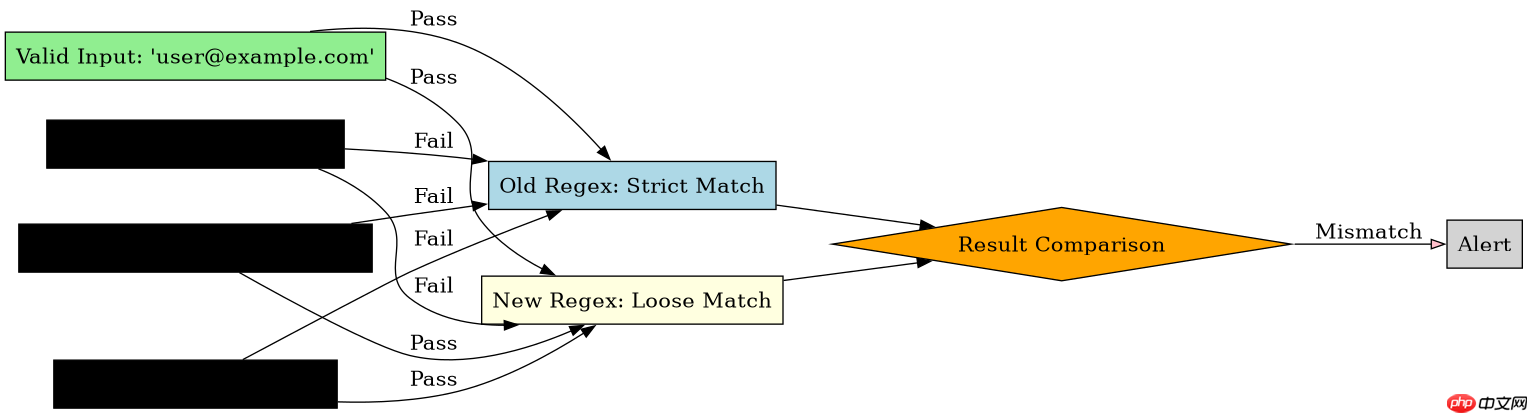
当正则表达式失去锚点约束时,它不再要求整个字符串完全符合模式,而是只要字符串中包含符合子模式的片段即可。例如,原本要求纯数字 ID 的规则,在简化后可能允许 ID 前后附带其他字符,导致格式错误的输入被系统接受。
import re

# 模拟一个更复杂的场景:邮箱校验
# 旧版:严格匹配完整邮箱格式
old_email_pattern = r'^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$'
# 新版:简化为只检查是否包含 @ 符号(错误简化)
new_email_pattern = r'@'

test_emails = ['user@example.com', 'invalid@', '@example.com', 'no-at-sign']
for email in test_emails:
    old_match = bool(re.match(old_email_pattern, email))
    new_match = bool(re.search(new_email_pattern, email))
    print(f"Email: {email} | Old Valid: {old_match} | New Valid: {new_match}")
基于程序中某个输入、条件或结果的具体问题
如果程序在升级后开始接受形如 ID-123extra 的输入,而之前拒绝该输入,这说明简化操作破坏了原有的边界检查逻辑。此时需要定位到正则定义的位置,检查是否有变量替换或字符串拼接操作意外移除了关键字符。






















