








在 linux 中,nginx 原生并不支持主动的健康检查,必须结合第三方模块(如 nginx_upstream_check_module)或采用被动健康检查机制来实现。若需实现主动探测,需编译安装带有该模块的 nginx 版本,并在 upstream 块中配置 check 指令;若使用标准版 nginx,则只能依赖客户端超时和重试机制进行被动的故障剔除。
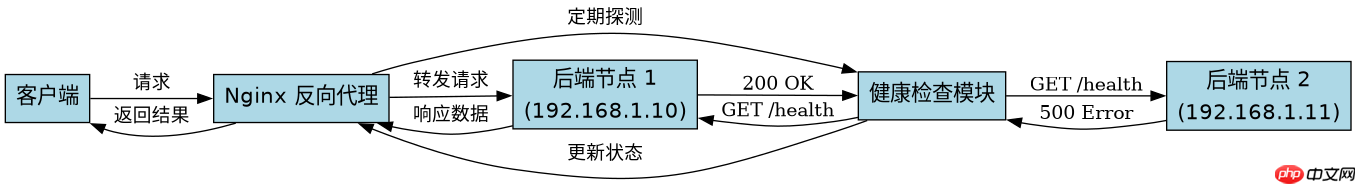
如何配置主动健康检查模块
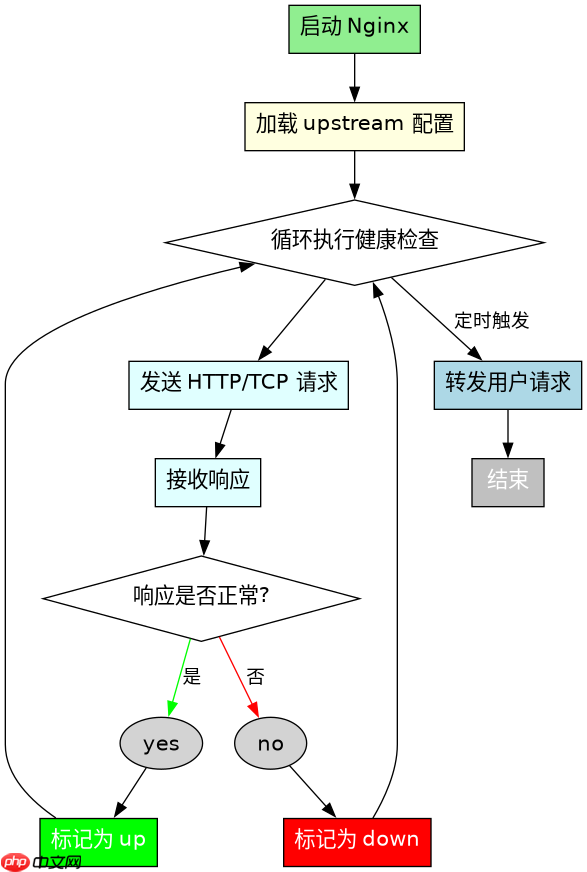
通过加载 nginx_upstream_check_module 模块,可以在 upstream 块中启用主动探测功能。该模块允许设置检查间隔、超时时间以及检查类型(HTTP 或 TCP),当后端服务器响应失败时,Nginx 会自动将其标记为不可用并停止转发流量。
events {
    worker_connections 1024;
}

http {
    upstream backend_pool {
        server 192.168.1.10:8080;
        server 192.168.1.11:8080;

        # 开启主动健康检查
        check interval=3000 rise=2 fall=5 timeout=1000 type=http;

        # 定义检查路径
        check_http_send "GET /health HTTP/1.0\r\n\r\n";
        check_http_expect_alive http_2xx http_3xx;
    }

    server {
        listen 80;
        location / {
            proxy_pass http://backend_pool;
        }
    }
}上述配置中,interval=3000 表示每 3 秒执行一次检查,rise=2 表示连续成功 2 次才恢复服务,fall=5 表示连续失败 5 次才剔除节点。检查类型为 http,请求路径为 /health,仅接受 2xx 和 3xx 状态码视为健康。若后端节点无 /health 接口,可改为 type=tcp 进行端口连通性检测。

被动健康检查与故障剔除机制
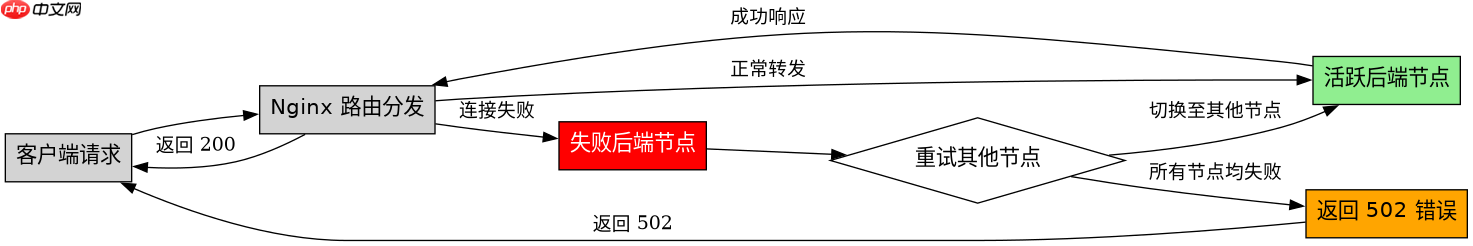
在不引入第三方模块的情况下,Nginx 默认采用被动健康检查策略。当客户端请求某后端节点失败(如连接拒绝或超时),Nginx 会将该节点暂时标记为不可用,并在一定时间内不再向其发送请求,直到再次尝试成功为止。这种机制无需额外配置,但响应延迟取决于客户端的重试行为。
events {
    worker_connections 1024;
}

http {
    upstream backend_pool {
        server 192.168.1.10:8080;
        server 192.168.1.11:8080;

        # 设置最大失败次数,超过后标记为 down
        max_fails=3;

        # 设置失败后的冷却时间(秒)
        fail_timeout=30s;
    }

    server {
        listen 80;
        location / {
            proxy_pass http://backend_pool;
            proxy_connect_timeout 5s;
            proxy_read_timeout 10s;
        }
    }
}在此配置中,max_fails=3 表示在 fail_timeout=30s 的时间窗口内,若某节点失败 3 次,则将其从可用列表中移除 30 秒。期间所有请求将被轮询到其他健康节点。若所有节点均不可用,Nginx 将返回 502 Bad Gateway。此方法简单可靠,适合对实时性要求不高的场景。
基于 proxy_pass 返回 502 错误的具体排查
当 proxy_pass 指向的 upstream 中所有节点均不可用时,Nginx 会向客户端返回 502 错误。此时应检查后端服务是否正常运行、网络连通性及 Nginx 日志中的错误信息。可通过 curl -v http://localhost 测试响应,并查看 /var/log/nginx/error.log 确认具体失败原因。



















