








java stream api 实现自定义 collector 需要创建一个实现了 collector 接口的类,并指定泛型参数以定义输入类型、累积器内部状态类型和最终结果类型。通过实现 supplier()、accumulator()、combiner()、finisher() 以及 characteristics() 这五个方法,可以完全控制流数据的收集逻辑,例如将元素分组、聚合或转换为特定集合。
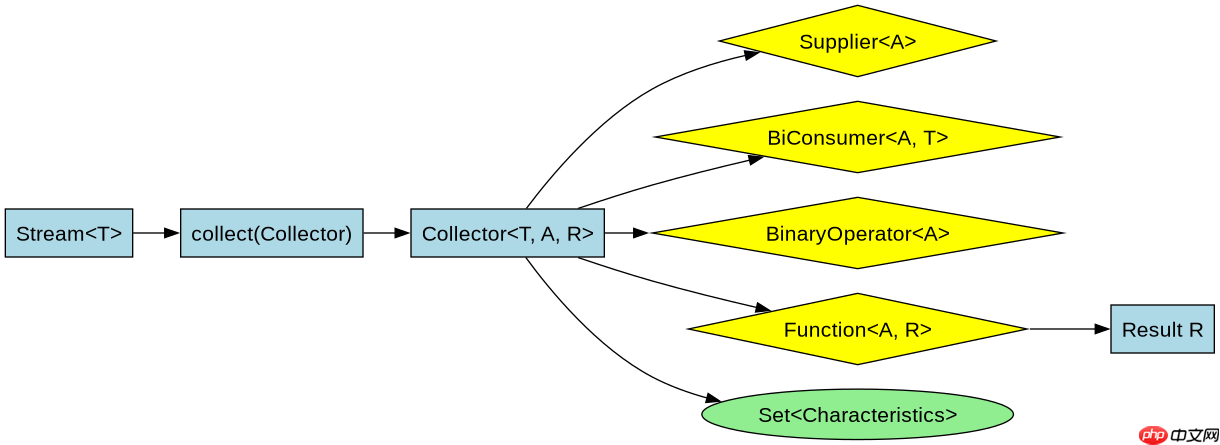
如何构建一个基础的字符串拼接 Collector
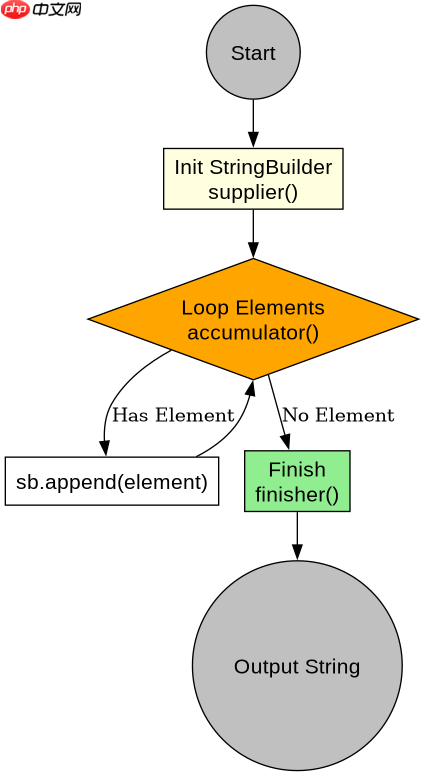
要实现一个将流中所有字符串拼接成单个大字符串的 Collector,必须定义好三个核心方法的逻辑。首先 supplier() 返回一个创建初始容器的函数,这里使用 StringBuilder;其次 accumulator() 定义如何将每个元素添加到容器中;最后 finisher() 将中间结果转换为目标类型。这种实现方式适用于需要自定义累加逻辑的场景,且能保持链式调用的简洁性。
import java.util.*;
import java.util.stream.Collector;

public class StringJoinCollector implements Collector<String, StringBuilder, String> {
    @Override
    public Supplier<StringBuilder> supplier() {
        return StringBuilder::new;
    }

    @Override
    public BiConsumer<StringBuilder, String> accumulator() {
        return (sb, s) -> sb.append(s);
    }

    @Override
    public BinaryOperator<StringBuilder> combiner() {
        return (left, right) -> {
            left.append(right);
            return left;
        };
    }

    @Override
    public Function<StringBuilder, String> finisher() {
        return StringBuilder::toString;
    }

    @Override
    public Set<Collector.Characteristics> characteristics() {
        return Collections.unmodifiableSet(EnumSet.of(Characteristics.IDENTITY_FINISH));
    }
}

// 使用示例
List<String> list = Arrays.asList("Hello", " ", "World");
String result = list.stream().collect(new StringJoinCollector());
System.out.println(result); // 输出: Hello World
如何处理并行流中的组合逻辑
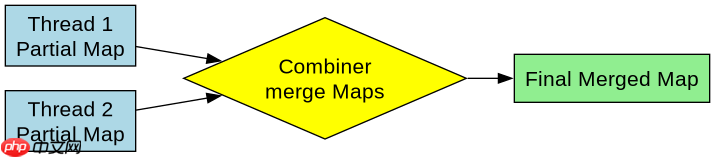
在并行流中,数据会被分割到多个线程中独立处理,因此 combiner() 方法变得至关重要。它负责将不同线程产生的部分结果合并成一个完整结果。如果忽略此方法或实现不当,并行执行可能会丢失数据或产生错误结果。对于不可变对象如 List,组合逻辑通常涉及创建新实例;而对于可变对象如 Map,则需确保线程安全或依赖外部同步机制。

立即学习“Java免费学习笔记(深入)”;
import java.util.*;
import java.util.stream.Collector;

public class GroupingByLengthCollector implements Collector<String, Map<Integer, List<String>>, Map<Integer, List<String>>> {
    @Override
    public Supplier<Map<Integer, List<String>>> supplier() {
        return HashMap::new;
    }

    @Override
    public BiConsumer<Map<Integer, List<String>>, String> accumulator() {
        return (map, str) -> {
            map.computeIfAbsent(str.length(), k -> new ArrayList<>()).add(str);
        };
    }

    @Override
    public BinaryOperator<Map<Integer, List<String>>> combiner() {
        return (map1, map2) -> {
            for (Map.Entry<Integer, List<String>> entry : map2.entrySet()) {
                map1.merge(entry.getKey(), entry.getValue(), List::addAll);
            }
            return map1;
        };
    }

    @Override
    public Function<Map<Integer, List<String>>, Map<Integer, List<String>>> finisher() {
        return Function.identity();
    }

    @Override
    public Set<Collector.Characteristics> characteristics() {
        return Collections.emptySet();
    }
}

// 使用示例
List<String> words = Arrays.asList("cat", "dog", "fish", "ant");
Map<Integer, List<String>> grouped = words.parallelStream()
    .collect(new GroupingByLengthCollector());
System.out.println(grouped); // 输出: {3=[cat, dog, ant], 4=[fish]}
基于程序中某个输入、条件或结果的具体问题
当输入列表为空时,自定义 Collector 的行为取决于 supplier() 的实现。如果 supplier() 返回一个空容器(如空 ArrayList),则最终结果将是该空容器经过 finisher() 转换后的值。若未正确处理空值情况,某些操作可能在 accumulator() 中抛出异常。确保 supplier() 始终返回有效实例是避免此类问题的关键,特别是在并行流中,空的子任务仍需能被正确组合。



















