








在java中实现异常翻译层,核心做法是定义一个自定义运行时异常类作为统一出口,并在业务逻辑外围使用try-catch块捕获底层抛出的具体异常,将其包装后重新抛出。这样调用方只需处理这一个顶层异常,无需感知内部复杂的异常体系。例如,当数据访问层抛出`sqlexception`时,服务层可以捕获它并转换为自定义的`dataaccessexception`,从而解耦业务代码与底层技术细节。

如何设计统一的异常基类
设计统一的异常基类是实现翻译层的第一步,通常继承自`RuntimeException`以支持非受检异常语义。这个基类应包含原始异常引用、错误码和简洁的错误信息,便于后续排查和前端展示。通过继承该基类,所有业务异常都能保持类型一致,方便上层进行统一拦截和处理。
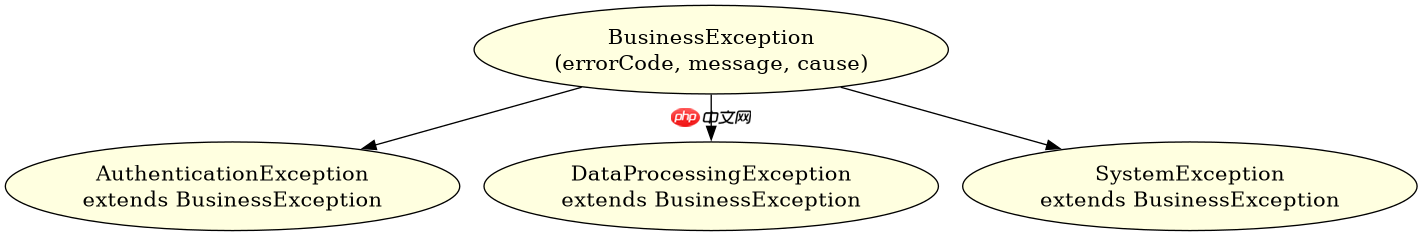
public class BusinessException extends RuntimeException {
    private final String errorCode;

    public BusinessException(String errorCode, String message, Throwable cause) {
        super(message, cause);
        this.errorCode = errorCode;
    }

    public String getErrorCode() {
        return errorCode;
    }
}
如何在Service层进行异常转换
在Service层进行异常转换时,需要在每个可能抛出底层异常的方法中包裹try-catch块。捕获具体的底层异常(如数据库异常或RPC异常),提取关键信息,然后实例化统一异常基类的子类并抛出。这种模式确保了业务逻辑的纯净性,同时提供了标准化的错误反馈机制。

立即学习“Java免费学习笔记(深入)”;

@Service
public class UserService {
    @Autowired
    private UserRepository userRepository;

    public User getUserById(Long id) {
        try {
            return userRepository.findById(id)
                .orElseThrow(() -> new NotFoundException("User not found"));
        } catch (DataAccessException e) {
            throw new BusinessException("DB_ERROR", "Database operation failed", e);
        }
    }
}
如何处理嵌套异常中的原始堆栈信息
在处理嵌套异常时,必须确保原始异常的堆栈信息不丢失,这对于生产环境的问题定位至关重要。Java的异常构造函数允许传入cause参数,自动保留完整的调用链。在日志记录或异常打印时,应优先打印cause的堆栈,而不是仅打印包装后的异常堆栈,这样才能快速定位到真正的故障点。


















