








第一步是使用静态分析工具对文件内容进行特征扫描,通过识别特定的函数调用、魔术常量或编码模式来初步判断加密类型。例如,若发现大量使用 base64_decode 配合 eval,通常指向简单的 base64 混淆;若检测到 gzinflate 或 gzuncompress,则可能是 php 的 gzip 压缩混淆;而若出现 str_rot13 或自定义的字符替换逻辑,则属于 rot13 类混淆。这些特征能直接揭示加密层级的性质,为后续的反混淆步骤提供方向。
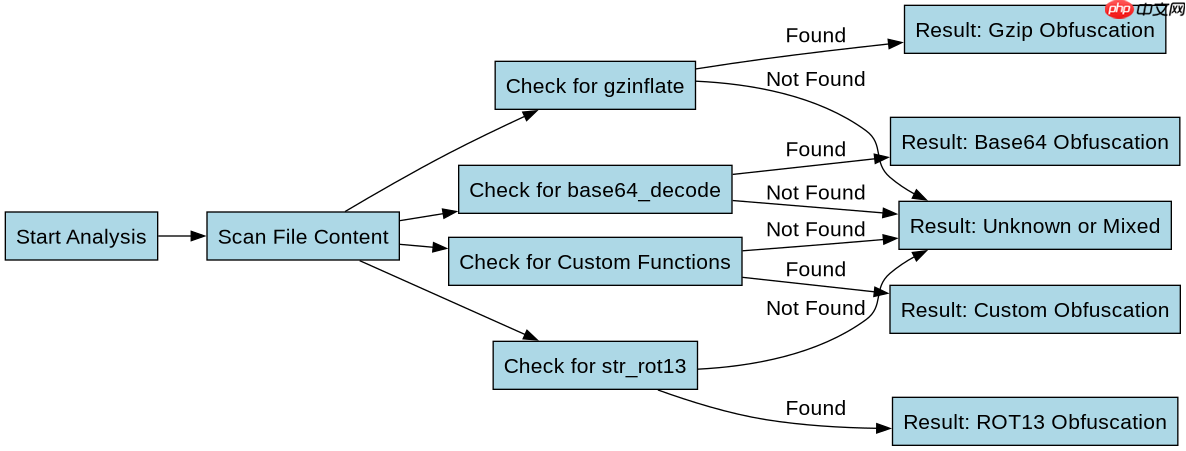
如何识别 Base64 与 Gzip 混淆特征?
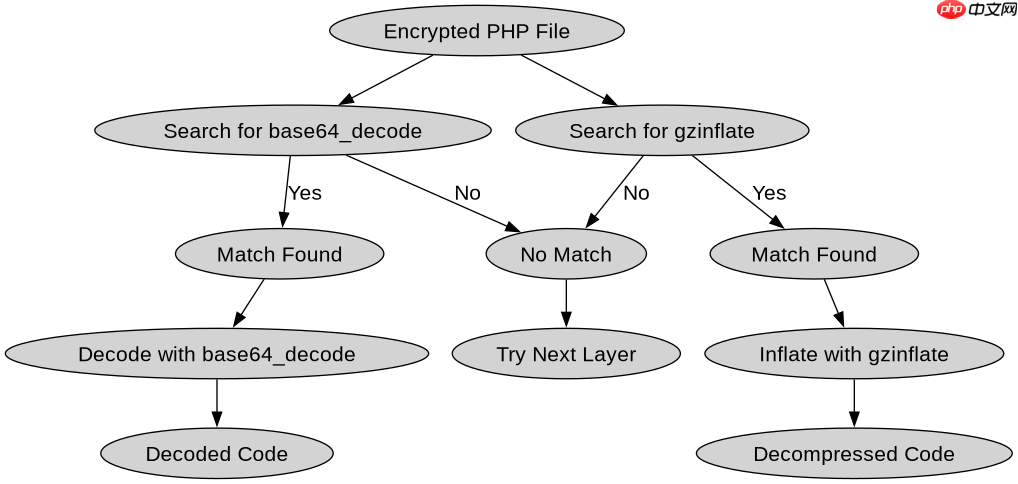
Base64 混淆和 Gzip 混淆是 PHP 中最常见的两种代码保护手段,它们的识别方法截然不同。Base64 混淆的核心在于将原始代码转换为不可读的字符串,因此文件中必然存在解码函数。开发者应搜索 base64_decode、base64_encode 或 convert_uudecode 等函数调用。如果找到这些函数,且其参数是一个长字符串,那么该字符串极有可能是被编码的代码。相比之下,Gzip 混淆利用的是 PHP 内置的压缩函数,如 gzinflate、gzuncompress 或 gzdecode。这类混淆后的代码通常以二进制数据形式存在,但在文本编辑器中查看时,可能会看到一些非 ASCII 字符或特定的魔数(Magic Number)。识别的关键在于查找这些解压函数的调用点,并观察其输入数据的格式。如果数据看起来像乱码但长度较短,且伴随解压函数,则很可能是 Gzip 混淆。
<?php
// 示例:检测 Base64 混淆
$code = file_get_contents('encrypted.php');
if (preg_match('/base64_decode\s*\(\s*["\']([A-Za-z0-9+/=]+)["\']\s*\)/', $code, $matches)) {
    echo "Detected Base64 encoding.\n";
    $decoded = base64_decode($matches[1]);
    echo $decoded;
}

// 示例:检测 Gzip 混淆
if (preg_match('/gzinflate\s*\(\s*["\']([A-Za-z0-9+/=]+)["\']\s*\)/', $code, $matches)) {
    echo "Detected Gzip inflation.\n";
    $inflated = gzinflate(base64_decode($matches[1]));
    echo $inflated;
}
?>
上述代码展示了如何通过正则表达式匹配常见的混淆函数。对于 Base64 混淆,我们寻找 base64_decode 及其参数,然后尝试解码并输出结果。对于 Gzip 混淆,我们寻找 gzinflate,同样解码后解压。需要注意的是,有些混淆器会将 Base64 编码的数据作为 Gzip 解压的输入,即先 gzinflate(base64_decode(...)),这种情况下需要嵌套处理。此外,还要留意 str_rot13 等简单替换,虽然它们不属于二进制混淆,但也属于加密范畴,可通过搜索 str_rot13 来识别。
立即学习“PHP免费学习笔记(深入)”;

如何区分自定义混淆与标准库混淆?
自定义混淆与标准库混淆的主要区别在于是否依赖 PHP 内置函数。标准库混淆直接使用 base64_decode、gzinflate 等函数,而自定义混淆则可能通过自定义函数或类来实现相同的逻辑。识别自定义混淆的第一步是检查文件中是否存在大量的自定义函数定义,特别是那些名称随机或无意义的函数。例如,如果看到一个名为 _0x1a2b 的函数,并且它在文件中被多次调用,那么它很可能是一个自定义的解密函数。其次,观察代码中是否有大量的字符串操作,如 str_replace、substr、chr 和 ord。这些函数常被用于实现字符替换或字节级操作,是自定义混淆的典型特征。此外,自定义混淆可能会使用 assert 或 eval 来执行动态生成的代码,这也是一个重要的信号。如果文件中没有明显的标准库混淆函数,但存在大量的字符串处理和动态执行逻辑,那么很可能是自定义混淆。

<?php
// 示例:检测自定义混淆
$code = file_get_contents('encrypted.php');

// 检查自定义函数
if (preg_match_all('/function\s+(_?[a-zA-Z0-9_]+)\s*\(/', $code, $functions)) {
    echo "Found custom functions: " . implode(', ', $functions[1]) . "\n";
}

// 检查字符串操作
if (preg_match('/str_replace|substr|chr|ord/', $code)) {
    echo "Detected string manipulation functions.\n";
}

// 检查动态执行
if (preg_match('/assert|eval/', $code)) {
    echo "Detected dynamic execution.\n";
}
?>
这段代码演示了如何检测自定义混淆的特征。首先,通过正则表达式提取所有函数定义,特别是那些以下划线开头或包含十六进制字符的函数名,这些通常是自定义混淆的标志。其次,检查是否存在 str_replace、substr 等字符串操作函数,这些函数常用于实现复杂的字符替换逻辑。最后,检查是否有 assert 或 eval 等动态执行函数,这些函数可能被用来执行解密后的代码。通过这些步骤,可以较为准确地判断文件是否使用了自定义混淆。需要注意的是,自定义混淆可能非常复杂,有时甚至结合了多种技术,因此需要结合具体的代码上下文进行综合分析。
当遇到多层嵌套混淆时该如何处理?
多层嵌套混淆是指代码经过多次不同形式的加密或混淆处理,例如先进行 Base64 编码,再进行 Gzip 压缩,最后再进行 ROT13 替换。处理这种复杂情况的关键是逐层剥离,从最外层开始,逐步还原代码。首先,识别最外层的混淆方式,这通常可以通过观察代码的结构和特征来判断。例如,如果最外层是 ROT13,那么整个文件的内容看起来像是经过 ROT13 处理的文本,可以通过应用 ROT13 解密来还原下一层。接下来,对解密后的内容再次进行分析,识别下一层的混淆方式,并重复上述过程。这个过程可能需要多次迭代,直到最终得到可读的源代码。在处理多层嵌套混淆时,建议使用自动化工具,如 dephell 或 php-unobfuscator,这些工具可以自动检测和剥离常见的混淆层。同时,手动分析也是必不可少的,因为自动化工具可能无法处理所有类型的混淆。在每一步解密后,都要验证结果是否合理,例如检查是否有语法错误或逻辑错误,以确保解密的正确性。



















