








服务器硬件故障应急预案的核心在于快速隔离故障节点、保障业务连续性并有序恢复数据。具体做法是建立自动化监控告警机制,一旦检测到关键硬件(如磁盘、电源、cpu)异常,立即触发预案流程:将流量切换至健康节点或备用集群,同时启动备件更换与数据重建程序。这能确保在物理修复完成前,服务不中断或仅短暂降级。
如何实时监控并自动切换故障节点
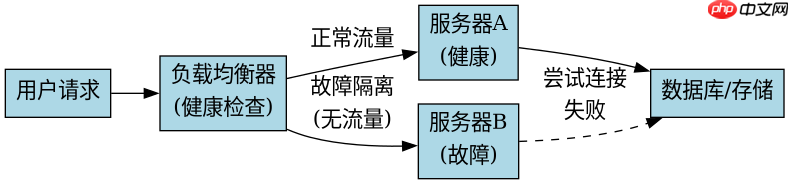
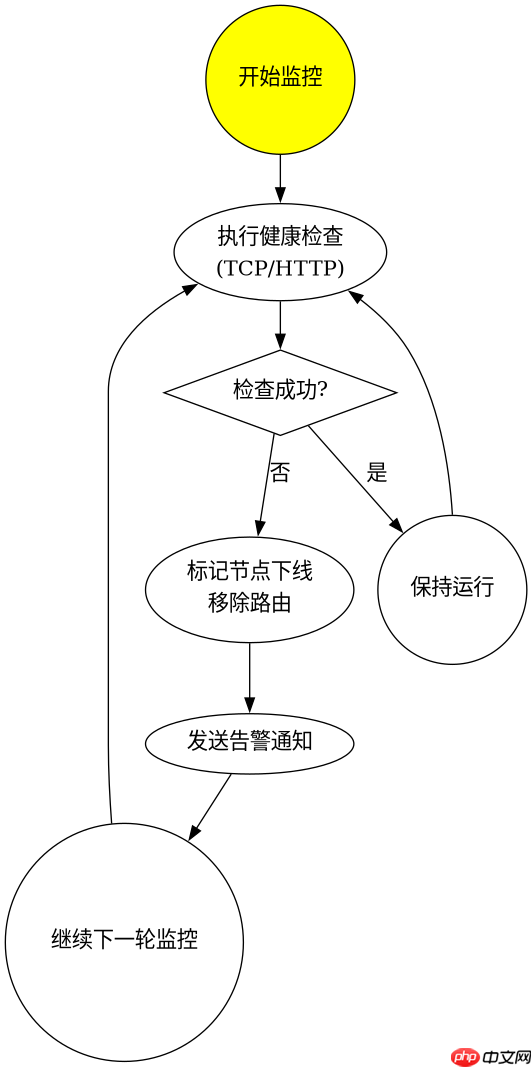
通过部署健康检查探针和负载均衡器,可以实时监测服务器状态并在故障发生时自动切断流量。当后端某台服务器的健康检查连续失败(例如3次TCP连接超时或HTTP 500错误),负载均衡器会将其标记为“下线”状态,不再向其分发新请求,从而防止用户访问到故障实例。这一过程通常由配置管理工具或云平台API自动执行,无需人工干预即可实现秒级隔离。
import time
import socket

def check_health(host, port, timeout=2):
    try:
        sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
        sock.settimeout(timeout)
        result = sock.connect_ex((host, port))
        sock.close()
        return result == 0
    except Exception as e:
        print(f"Health check failed for {host}:{port} - {e}")
        return False

# 模拟监控循环
servers = ['192.168.1.10', '192.168.1.11']
while True:
    for server in servers:
        if not check_health(server, 80):
            print(f"ALERT: {server} is down! Switching traffic.")
            # 此处应调用负载均衡器API移除该节点
        else:
            print(f"OK: {server} is healthy.")
    time.sleep(5)
上述代码演示了基础的健康检查逻辑。在实际生产环境中,应结合Prometheus或Zabbix等监控系统,将检查结果作为指标上报。当指标超过阈值时,触发Webhook通知运维平台,由平台执行节点剔除操作。预期结果是故障节点被迅速从可用池中移除,业务流量自动路由至剩余健康节点。
故障替换后数据如何快速同步恢复
在物理硬盘或整机更换完成后,新节点加入集群需通过数据同步机制恢复一致性。对于分布式存储系统(如Ceph或HDFS),新节点会自动从其他健康副本中拉取缺失的数据块;对于数据库主从架构,新从库可通过binlog回放或全量备份+增量日志的方式追平主库数据。关键在于预先配置好自动复制策略,确保新硬件上线后能无缝接管数据读写任务。

# 模拟Ceph OSD替换后的数据重平衡过程
# 假设新OSD加入集群,触发scrub和rebalance

import subprocess

# 1. 添加新OSD设备
subprocess.run(['ceph-volume', 'lvm', 'create', '/dev/sdb'])

# 2. 检查集群状态,确认PGs处于active+clean
result = subprocess.run(['ceph', 'status'], capture_output=True, text=True)
print(result.stdout)

# 3. 监控重平衡进度
while True:
    status = subprocess.run(['ceph', 'pg stat'], capture_output=True, text=True)
    if 'degraded' in status.stdout or 'incomplete' in status.stdout:
        print("Data rebalancing in progress...")
        time.sleep(10)
    else:
        print("Rebalancing complete. Cluster is healthy.")
        break
该脚本展示了新OSD加入后的基本验证步骤。实际恢复过程中,系统会根据负载自动调整数据迁移速率,避免影响正常业务IO。预期结果是集群在数小时至数十小时内(取决于数据量)恢复至完全健康状态,期间服务保持可用但可能伴随轻微延迟。
如果监控误报导致流量切换怎么办
当监控因网络抖动或瞬时高负载产生误报,导致健康节点被错误剔除时,应立即执行手动回滚操作。运维人员需登录负载均衡控制台或通过CLI命令,将之前标记为“下线”的节点重新设为“在线”状态,并验证其健康检查是否恢复正常。同时,需排查误报原因(如调整超时阈值或增加重试次数),防止同类问题再次发生。此过程强调人工介入的快速决策能力,以最小化因自动化误判带来的服务波动。


















