








JDBC 嵌套事务的核心机制是什么
java jdbc 中所谓的“嵌套事务”并非指数据库原生的 savepoint 自动管理,而是通过手动设置 setsavepoint() 和 rollback() 来实现的局部回滚。其核心做法是:在开启的事务中创建保存点,执行子逻辑;若子逻辑失败,仅回滚到该保存点,外层事务继续运行或最终提交。这要求底层数据库支持 savepoint(如 mysql、postgresql),且连接必须处于非自动提交模式。

如何编写带保存点的嵌套事务代码
实现嵌套事务的具体步骤是:获取 Connection 后调用 setAutoCommit(false),在外层业务开始前记录主保存点或直接开始,进入内层业务前调用 createSavepoint() 创建命名保存点,内层异常时捕获并 rollback(svp),最后统一提交。这样即使内层数据写入失败,也不会影响外层已提交的数据。
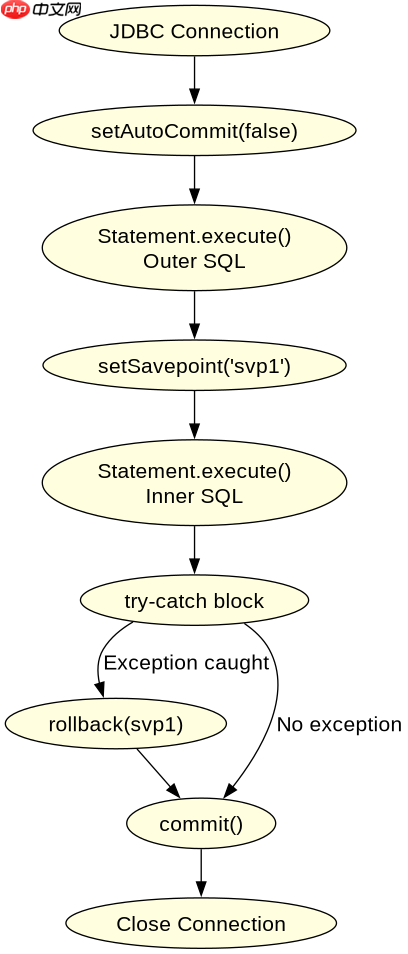

import java.sql.*;

public class NestedTransactionExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            Statement stmt = conn.createStatement();

            // 2. 外层操作:插入用户信息
            stmt.executeUpdate("INSERT INTO users (name) VALUES ('Alice')");

            // 3. 创建保存点,准备进行内层操作
            Savepoint svp = conn.setSavepoint("inner_op_savepoint");

            try {
                // 4. 内层操作:尝试插入订单(假设会因约束失败)
                stmt.executeUpdate("INSERT INTO orders (user_id, amount) VALUES (999, 100)");
                // 如果上面成功,这里不会执行
                System.out.println("Inner operation succeeded.");
            } catch (SQLException e) {
                // 5. 内层失败,回滚到保存点
                System.out.println("Inner operation failed, rolling back to savepoint.");
                conn.rollback(svp);
            }

            // 6. 提交整个事务
            conn.commit();
            System.out.println("Transaction committed successfully.");

        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
嵌套事务在不同数据库中的行为差异有哪些
虽然 JDBC API 提供了标准的 Savepoint 接口,但不同数据库对嵌套事务的支持程度和默认行为存在差异。例如,MySQL 的 InnoDB 引擎完全支持 Savepoint,允许在事务中多次创建和回滚到保存点。而某些数据库或配置下,可能不支持嵌套事务,或者将 Savepoint 视为独立事务。此外,Spring 框架的 @Transactional 注解在处理嵌套事务时,会根据传播行为(如 REQUIRES_NEW 或 SUPPORTS)决定是挂起当前事务还是加入现有事务,这与原生 JDBC 的手动控制有所不同。在实际开发中,应优先使用 Spring 等框架的高级抽象,除非有特殊的性能或控制需求才直接使用 JDBC 原生 API。
立即学习“Java免费学习笔记(深入)”;


















