








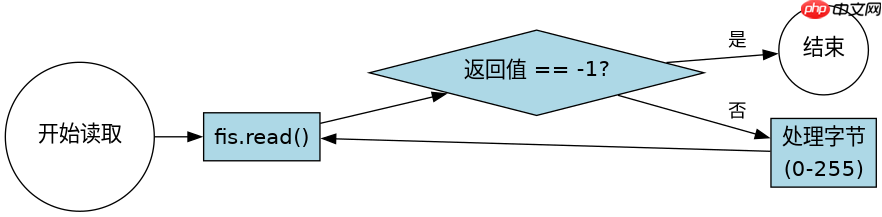
在 java 中,`fileinputstream` 的 `read()` 方法主要用于从文件中读取原始字节数据。最常用的方式是调用无参的 read(),它会返回一个 int 类型的值,该值代表读取到的字节的实际内容(0-255),如果到达文件末尾则返回 -1。开发者通常在一个循环中调用此方法,直到返回值等于 -1 为止,从而将文件内容完整读入内存或缓冲区。
如何正确使用 read() 进行循环读取
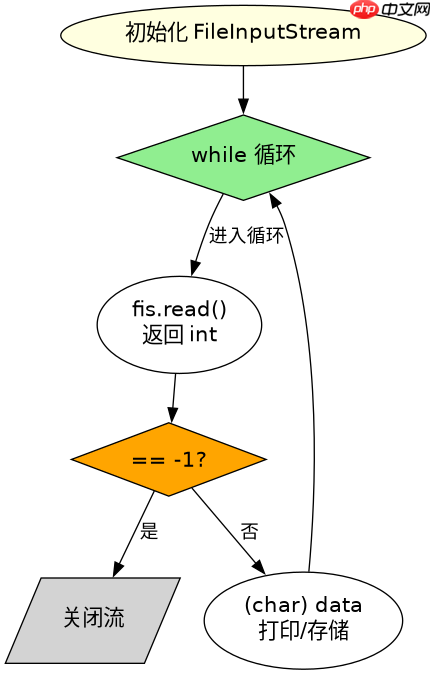
要正确读取文件,必须使用 while 循环配合 read() 的返回值判断。每次调用 read() 都会从当前指针位置读取一个字节。由于返回值是 int,直接将其赋值给 byte 变量时需要注意类型转换,或者直接将结果存入 byte[] 数组中。当 read() 返回 -1 时,表示没有更多数据可读取,此时应终止循环并关闭流。
import java.io.FileInputStream;
import java.io.IOException;

public class ReadExample {
    public static void main(String[] args) {
        try (FileInputStream fis = new FileInputStream("test.txt")) {
            int data;
            while ((data = fis.read()) != -1) {
                System.out.print((char) data);
            }
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了最基础的单字节读取方式。在实际开发中,为了提高效率,更推荐使用带缓冲区的 read(byte[] b) 方法,一次性读取多个字节。但无论哪种方式,核心逻辑都是检查返回值是否为 -1 以判断文件结束。
立即学习“Java免费学习笔记(深入)”;

read(byte[]) 与 read() 的性能差异及选择
虽然 read() 可以工作,但在处理大文件时,频繁的系统调用会导致性能瓶颈。read(byte[] b) 方法允许指定一个缓冲区数组,一次读取最多 b.length 个字节,并返回实际读取的字节数。这种方式减少了 I/O 操作的次数,显著提升了读取速度。开发者应根据文件大小和性能需求选择合适的读取策略。

import java.io.FileInputStream;
import java.io.IOException;

public class BufferedReadExample {
    public static void main(String[] args) {
        try (FileInputStream fis = new FileInputStream("test.txt")) {
            byte[] buffer = new byte[1024];
            int bytesRead;
            while ((bytesRead = fis.read(buffer)) != -1) {
                // 处理读取到的数据,注意只处理 bytesRead 长度的部分
                String content = new String(buffer, 0, bytesRead);
                System.out.print(content);
            }
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
在使用 read(byte[] b) 时,务必注意返回值 bytesRead。它可能小于缓冲区的长度,特别是在读取文件的最后一块数据时。因此,在将字节数组转换为字符串或其他对象时,必须使用 new String(buffer, 0, bytesRead) 这样的构造函数,以确保不会包含未读取的垃圾数据。
当 read() 遇到非 UTF-8 编码的文件时会发生什么
如果文件内容不是标准的 ASCII 或 UTF-8 编码(例如 GBK 编码的中文文件),直接使用 (char) data 强制转换单个字节会导致乱码。这是因为多字节字符被拆分成了独立的字节,每个字节单独转换后无法还原为正确的字符。此时,应当使用 InputStreamReader 包装 FileInputStream,并指定正确的字符集(如 "GBK"),由解码器负责将字节流转换为字符流,从而正确处理多字节字符。


















