








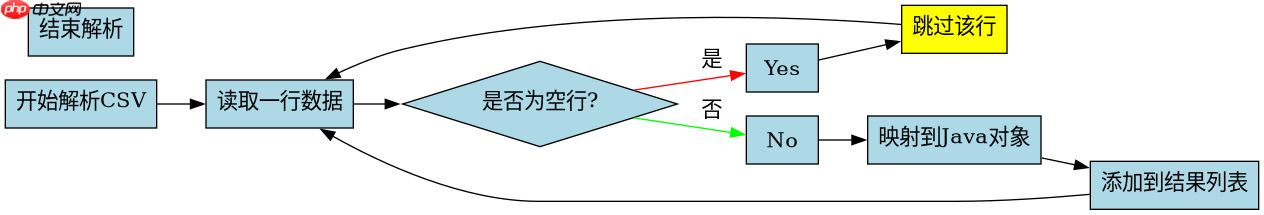
在spring data csv中处理空行,核心做法是配置 emptylinepolicy 为 skip。默认情况下,csv解析器遇到连续换行符产生的空行会抛出异常或返回空对象,导致解析中断。通过自定义 csvmapperfactory 并设置策略,可以忽略这些无效数据,确保只处理包含有效数据的行。
如何配置CsvMapperFactory以跳过空行?
直接回答:需要继承 CsvMapperFactory 并重写 getEmptyLinePolicy() 方法,将其返回值改为 EmptyLinePolicy.SKIP。这样配置后,解析器在读取到空行时会直接跳过,不会尝试映射字段,从而避免 MappingException。
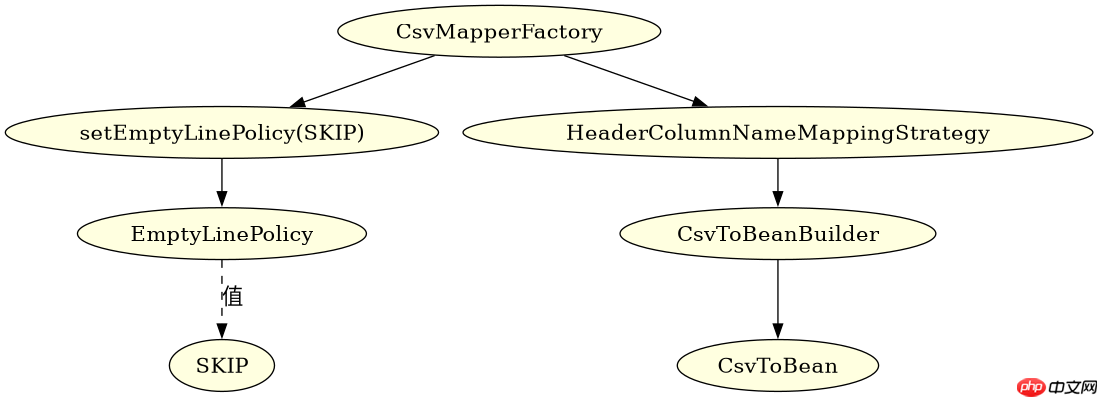
import com.opencsv.bean.CsvToBeanBuilder; import com.opencsv.bean.CsvToBean; import com.opencsv.bean.CsvMapperFactory; import com.opencsv.bean.HeaderColumnNameMappingStrategy; import com.opencsv.exceptions.CsvException; import java.io.FileReader; import java.util.List; public class CsvConfig { public static void main(String[] args) throws CsvException { // 1. 创建工厂实例 CsvMapperFactory factory = new CsvMapperFactory(); // 2. 配置空行策略为 SKIP factory.setEmptyLinePolicy(com.opencsv.bean.EmptyLinePolicy.SKIP); // 3. 构建解析器 HeaderColumnNameMappingStrategy<User> mappingStrategy = new HeaderColumnNameMappingStrategy<>(); mappingStrategy.setType(User.class); // 4. 执行解析 try (FileReader reader = new FileReader("data.csv")) { CsvToBean<User> csvToBean = CsvToBeanBuilder.of(reader) .withMappingStrategy(mappingStrategy) .withType(User.class) .withFieldExclusionList() // 可选:排除特定字段 .withIgnoreLeadingWhiteSpace(true) // 可选:忽略前导空格 .build(); List<User> users = csvToBean.parse(); System.out.println("成功解析 " + users.size() + " 条记录"); } } } 上述代码展示了完整的配置流程。关键点在于 factory.setEmptyLinePolicy(...) 这一行。如果不设置,默认行为通常是 STOP 或 THROW_EXCEPTION,这会导致程序在处理包含空行的CSV文件时崩溃。通过显式设置为 SKIP,我们告诉解析器将空行视为“无数据”,从而安全地继续处理下一行。
立即学习“Java免费学习笔记(深入)”;

如何处理空行导致的字段映射错误?
直接回答:除了跳过空行,还需确保 HeaderColumnNameMappingStrategy 正确识别列头。如果空行出现在表头之后、数据之前,且未配置 SKIP,解析器可能尝试将空行映射为 User 对象,导致所有字段为 null 或触发验证错误。结合 SKIP 策略和适当的输入流处理,可以避免此类问题。

import com.opencsv.bean.CsvToBean; import com.opencsv.bean.CsvToBeanBuilder; import com.opencsv.bean.HeaderColumnNameMappingStrategy; import com.opencsv.exceptions.CsvException; import java.io.StringReader; import java.util.List; public class EmptyLineTest { public static void main(String[] args) throws CsvException { String csvData = "name,age\nAlice,30\n\nBob,25\n"; // 模拟包含空行的CSV内容 HeaderColumnNameMappingStrategy<User> strategy = new HeaderColumnNameMappingStrategy<>(); strategy.setType(User.class); // 关键:应用之前的工厂配置(此处简化演示) com.opencsv.bean.CsvMapperFactory factory = new com.opencsv.bean.CsvMapperFactory(); factory.setEmptyLinePolicy(com.opencsv.bean.EmptyLinePolicy.SKIP); CsvToBean<User> csvToBean = CsvToBeanBuilder.of(new StringReader(csvData)) .withMappingStrategy(strategy) .withType(User.class) .withFieldExclusionList() .build(); List<User> users = csvToBean.parse(); // 预期结果:users列表包含 Alice 和 Bob,不包含空行对应的对象 users.forEach(u -> System.out.println(u.getName() + ": " + u.getAge())); } } 在这个测试用例中,csvData 字符串包含一个明显的空行(\n\n)。由于我们已经在 CsvMapperFactory 中设置了 SKIP 策略,csvToBean.parse() 会忽略中间的空行,只返回两个有效的 User 对象。如果没有这个配置,解析器可能会抛出异常或返回一个包含 null 字段的无效对象,具体取决于底层库的版本和默认行为。此示例验证了配置的有效性。
当CSV文件中存在多个连续空行时会发生什么?
直接回答:当存在多个连续空行时,EmptyLinePolicy.SKIP 策略会逐个跳过它们,不会引发错误或生成额外的空对象。解析器会持续读取直到找到下一个非空行或到达文件末尾。这意味着无论空行数量多少,只要它们之间没有有效数据,就不会影响最终的结果集大小。



















