








线程上下文切换是指cpu从一个线程的执行状态切换到另一个线程执行状态的过程,其核心动作是保存当前线程的寄存器、程序计数器等硬件状态到内存,并加载新线程的状态。在java中,这通常由操作系统内核完成,涉及用户态与内核态的转换以及缓存失效,属于高开销操作。
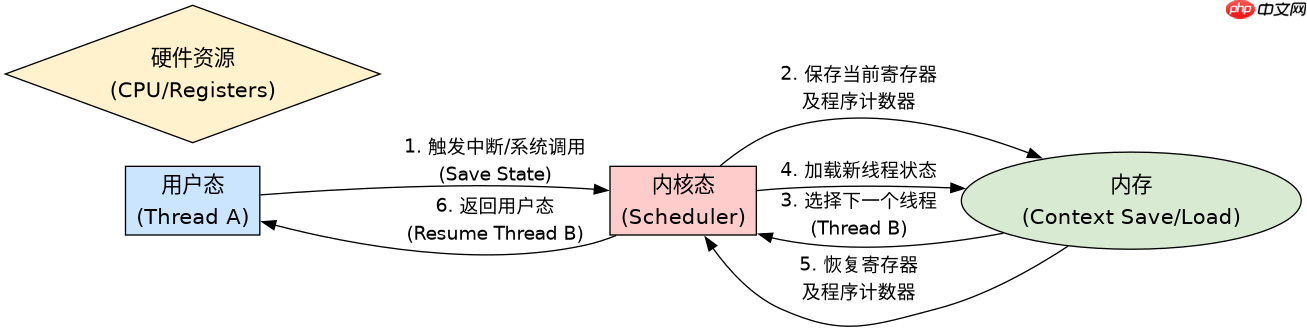
为什么线程切换会导致性能下降
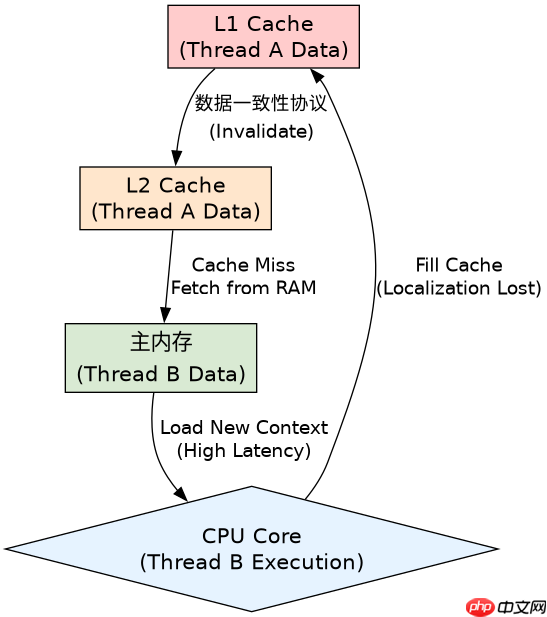
线程切换导致性能下降的主要原因是它破坏了CPU的局部性原理并触发了昂贵的系统调用。当线程被挂起时,其对应的CPU缓存(L1/L2)中的数据可能因时间推移而失效,新线程的数据需要重新从主存加载,造成Cache Miss。此外,切换过程本身需要进入内核态,执行复杂的调度算法和状态保存/恢复指令,这些都不产生实际的业务计算价值。
public class ContextSwitchDemo {
    public static void main(String[] args) throws InterruptedException {
        // 创建两个简单的线程
        Thread t1 = new Thread(() -> {
            long sum = 0;
            for (int i = 0; i < 1000000; i++) sum += i;
        }, "Thread-1");

        Thread t2 = new Thread(() -> {
            long sum = 0;
            for (int i = 0; i < 1000000; i++) sum += i;
        }, "Thread-2");

        // 启动线程
        t1.start();
        t2.start();

        // 等待结束
        t1.join();
        t2.join();
        System.out.println("Done");
    }
}
如何减少不必要的上下文切换
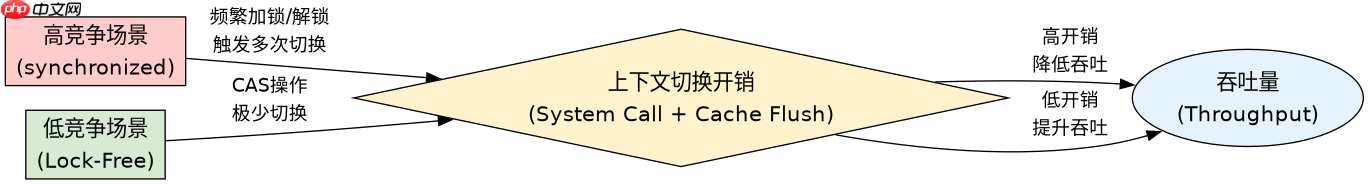
减少上下文切换的关键在于降低线程调度的频率和优化锁的使用策略。可以通过使用无锁数据结构(如ConcurrentHashMap)、减少锁的粒度、使用ThreadLocal避免共享变量竞争,或者将任务合并为批量处理来减少线程数量。此外,合理设置线程池大小,使其接近CPU核心数而非盲目增加,也能有效缓解切换压力。

立即学习“Java免费学习笔记(深入)”;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.atomic.AtomicLong;

public class LockFreeExample {
    private final ConcurrentHashMap<String, AtomicLong> map = new ConcurrentHashMap<>();

    public void increment(String key) {
        // 使用computeIfAbsent和addAndGet实现无锁更新
        map.computeIfAbsent(key, k -> new AtomicLong(0)).incrementAndGet();
    }

    public long getCount(String key) {
        return map.getOrDefault(key, new AtomicLong(0)).get();
    }

    public static void main(String[] args) {
        LockFreeExample example = new LockFreeExample();
        // 模拟并发操作
        for (int i = 0; i < 100; i++) {
            new Thread(() -> example.increment("counter")).start();
        }
    }
}
同步块内的wait()对上下文切换的影响
在同步块内调用wait()会释放对象监视器锁并使当前线程进入WAITING状态,这会立即触发一次上下文切换。线程从阻塞变为可运行状态后,需要重新获取锁才能继续执行,这又涉及另一次切换。因此,频繁地进入和退出同步块会显著增加切换次数。优化方法是尽量缩小synchronized代码块的范围,或使用ReentrantLock配合Condition.await()进行更精细的控制。

















