








storeload 屏障是 java volatile 关键字在底层实现内存可见性和有序性时,由编译器或处理器生成的特定指令,用于强制刷新 cpu 缓存并清空写缓冲区。它主要出现在对 volatile 变量进行写操作之后(如果是读操作则通常不需要),确保该 volatile 写之前的所有普通内存写入都同步到主内存,从而让后续读取该变量的线程能看到最新的值。
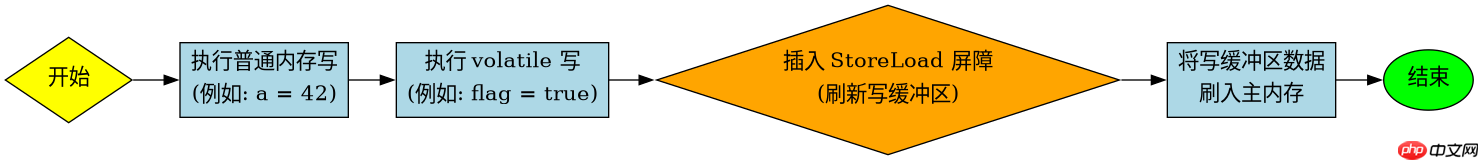
volatile 写操作后的 StoreLoad 屏障如何工作
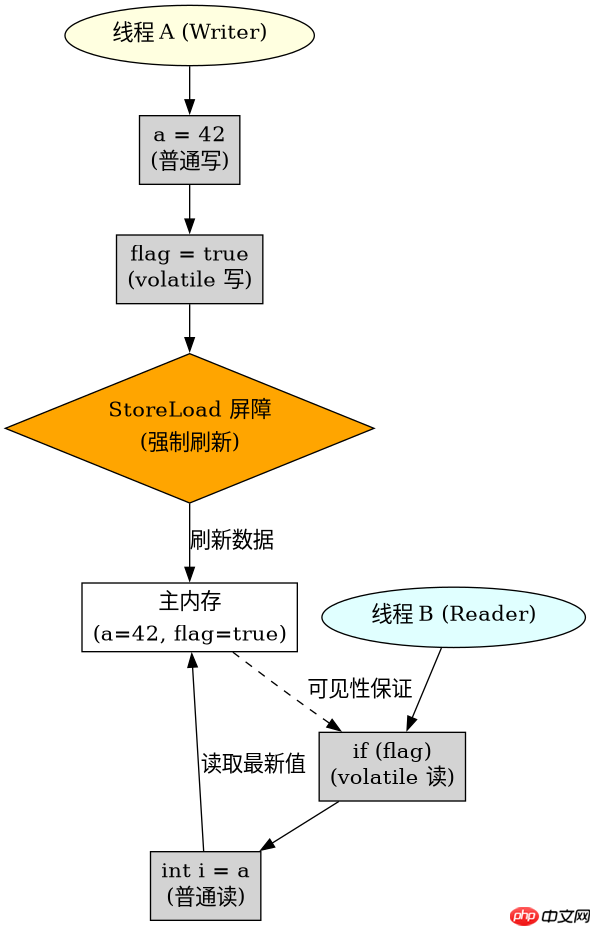
当代码中对一个 volatile 变量执行写操作时,JVM 会在该写指令后插入一条 StoreLoad 屏障。这条屏障的作用是防止编译器和处理器将 volatile 写之前的普通写操作重排序到 volatile 写之后。具体来说,它会强制将写缓冲区(Write Buffer)中的数据全部刷入主内存,并禁止任何后续的内存访问指令与该写操作交换顺序。这保证了在多线程环境下,其他线程在读取这个 volatile 变量时,能够看到该 volatile 写之前所有共享变量的最新状态。
public class VolatileExample {
    private int a = 0;
    private volatile boolean flag = false;

    public void writer() {
        a = 42; // 普通写
        flag = true; // volatile 写,此处隐含 StoreLoad 屏障
    }

    public void reader() {
        if (flag) { // volatile 读,隐含 LoadLoad 和 LoadStore 屏障
            int i = a; // 保证读到 a=42
            System.out.println(i);
        }
    }
}
为什么 volatile 读不需要 StoreLoad 屏障
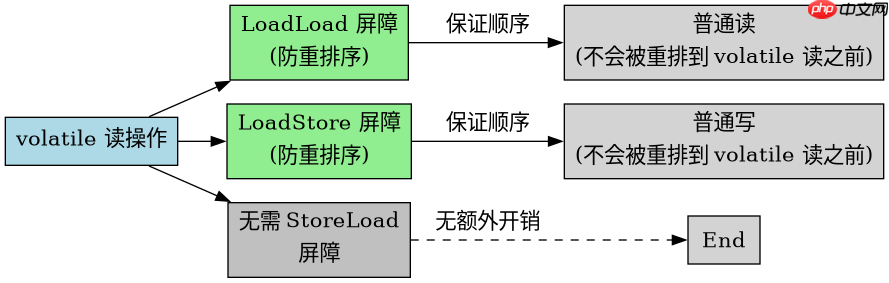
与写操作不同,volatile 的读操作并不需要在末尾添加 StoreLoad 屏障。这是因为读操作的主要目的是获取最新的值,而不是向其他线程发布数据。volatile 读的语义要求在读指令前插入 LoadLoad 屏障(防止读后面的普通读被重排序到 volatile 读之前)和 LoadStore 屏障(防止读后面的普通写被重排序到 volatile 读之前)。由于读操作本身不涉及将本地缓存的数据推送到主内存的动作,因此不需要像写操作那样使用昂贵的 StoreLoad 屏障来刷新写缓冲区。这种不对称的设计既保证了正确性,又优化了性能。

立即学习“Java免费学习笔记(深入)”;
public class VolatileReadExample {
    private volatile int value = 0;
    private int other = 0;

    public void reader() {
        int v = value; // volatile 读,隐含 LoadLoad/LoadStore
        other = v;     // 普通写,不会重排序到 volatile 读之前
    }

    public void writer() {
        other = 10;
        value = 20; // volatile 写,隐含 StoreLoad
    }
}
StoreLoad 屏障在不同硬件架构上的表现
StoreLoad 屏障的具体实现依赖于底层硬件架构。在 x86 架构下,由于其内存模型相对宽松,x86 处理器通常只处理写-读(Write-Read)的重排序问题,而读-写、读-读等重排序较少见。因此,在 x86 上,volatile 的读操作通常不需要插入任何屏障指令,而写操作则需要插入一个类似 lfence 的指令来实现 StoreLoad 的效果。而在 ARM 或 PowerPC 等弱一致性内存模型的架构上,必须显式插入完整的 StoreLoad 屏障指令(如 dmb ish 在 ARM 上)来确保内存顺序。这意味着 Java 程序在不同平台上运行时,JVM 会根据目标平台的特性生成不同的汇编代码,但对外提供的 Java 语义保持一致。


















