








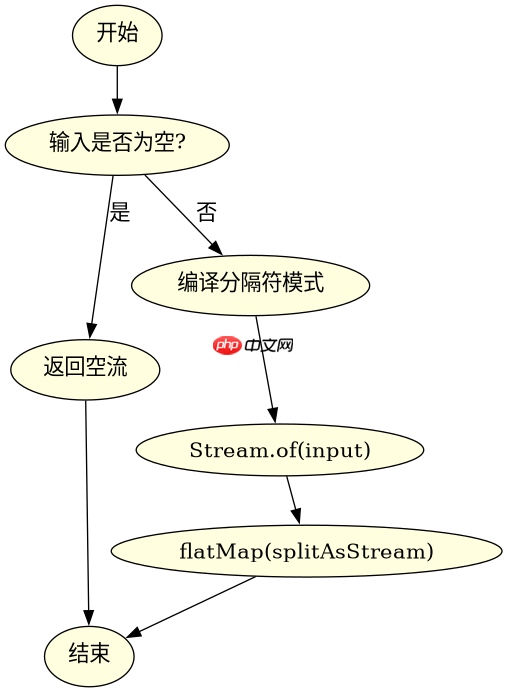
使用 stream.of() 结合 flatmap() 和 pattern.splitasstream() 可以将字符串按分隔符拆分为流。具体做法是创建一个包含该字符串的单元素流,通过 flatmap 将每个字符串映射为其对应的分割结果流,最终合并为一个扁平化的 stream<string></string>。若输入为空或仅含分隔符,结果为空流;若未指定分隔符,默认行为取决于正则表达式的匹配规则。

如何对单个字符串执行拆分并展平为流
直接调用 Pattern.compile(delimiter).splitAsStream(input) 获取子串流,再将其包裹在 Stream.of() 中并通过 flatMap 展平。这样处理单行文本时,无需手动循环即可得到连续的 token 流。如果分隔符是固定字符而非正则,建议使用 String.split() 配合 Arrays.stream() 以获得更好的性能表现。
import java.util.stream.Stream;
import java.util.regex.Pattern;

public class Tokenizer {
    public static Stream<String> tokenize(String input, String delimiter) {
        if (input == null || input.isEmpty()) {
            return Stream.empty();
        }
        Pattern pattern = Pattern.compile(Pattern.quote(delimiter));
        return Stream.of(input)
                .flatMap(s -> pattern.splitAsStream(s));
    }

    public static void main(String[] args) {
        Stream<String> tokens = tokenize("hello world", " ");
        tokens.forEach(System.out::println);
    }
}
预期输出:
hello
world
立即学习“Java免费学习笔记(深入)”;

如何处理多行文本的批量拆分
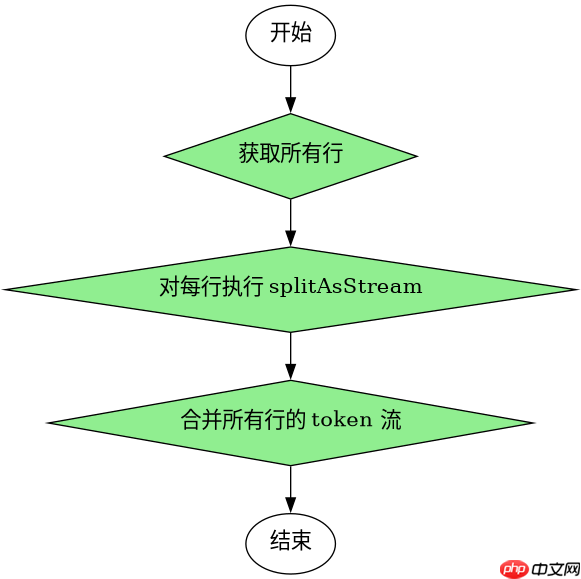
当输入为多行字符串时,可先按行切分,再对每行应用相同的拆分逻辑。通过 String.lines()(Java 11+)或 BufferedReader.readAllLines() 获取行列表,随后使用 flatMap 将每一行映射为 token 流并合并。这种方式适用于日志解析或 CSV 预处理等场景,能保持流的惰性求值特性。
import java.util.stream.Stream;
import java.util.regex.Pattern;

public class MultiLineTokenizer {
    public static Stream<String> tokenizeLines(String multiLineInput, String delimiter) {
        if (multiLineInput == null || multiLineInput.isEmpty()) {
            return Stream.empty();
        }
        Pattern pattern = Pattern.compile(Pattern.quote(delimiter));
        return multiLineInput.lines()
                .flatMap(line -> pattern.splitAsStream(line));
    }

    public static void main(String[] args) {
        String text = "apple,banana\norange,grape";
        Stream<String> tokens = tokenizeLines(text, ",");
        tokens.forEach(System.out::println);
    }
}
预期输出:
apple
banana
orange
grape
当输入包含连续分隔符时流的行为是什么
若输入字符串中存在连续的分隔符,如 a,,b,splitAsStream 会生成一个空字符串元素作为中间 token。例如,"a,,b".split(",") 返回 ["a", "", "b"],因此流中会包含一个空字符串项。若需过滤掉空值,可在 flatMap 后追加 .filter(s -> !s.isEmpty())。此行为与 String.split() 一致,但不会丢弃尾随空字符串,除非显式指定限制参数。


















