








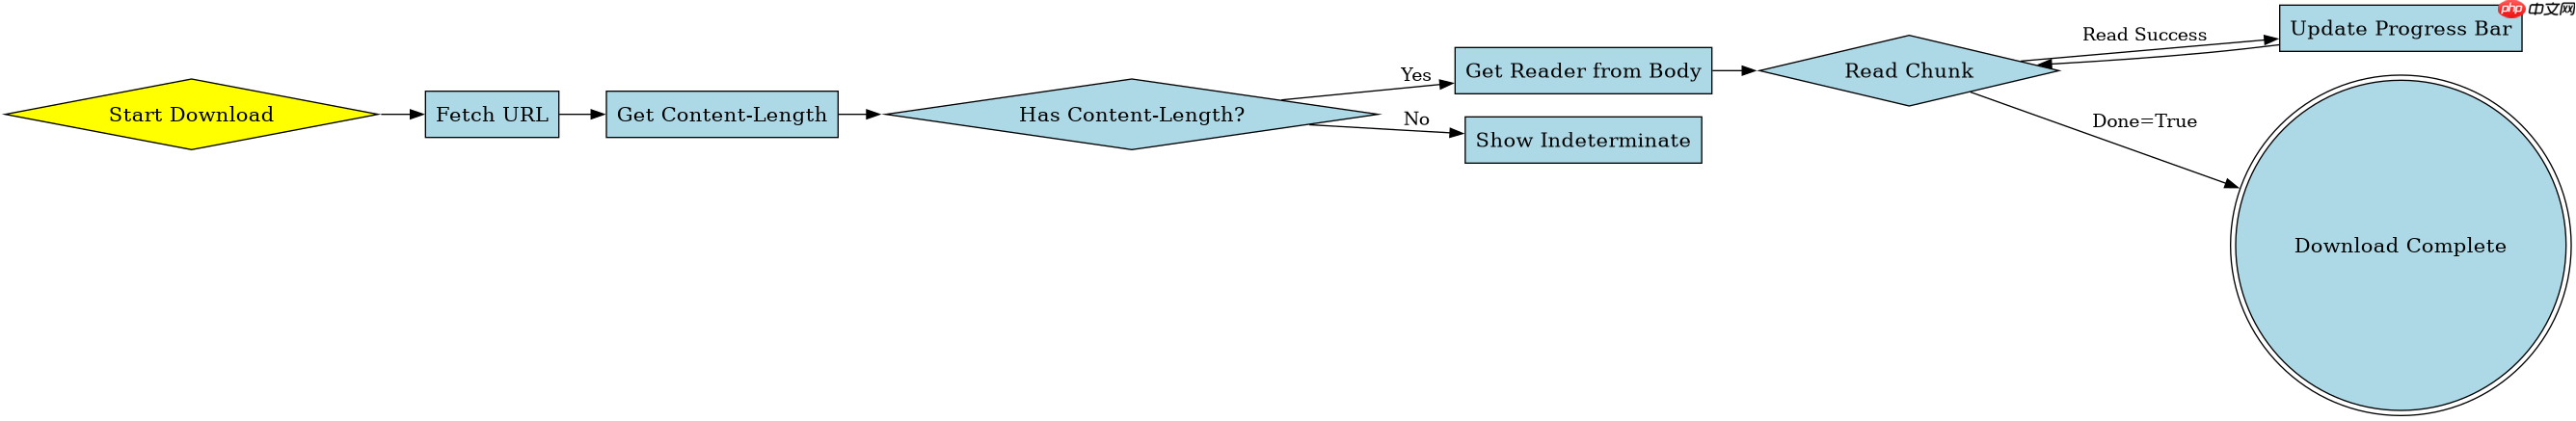
使用 fetch 下载文件并获取进度,核心在于将 response 的 body 转换为可读的 readablestream,通过监听流中的 ondata 事件累计已接收字节数,并与响应头中的 content-length 对比计算百分比。具体做法是调用 response.body.getreader() 获取读取器,在循环中调用 read() 方法,直到 done 为真时停止,期间实时触发进度回调。
如何解析 Fetch 响应头以获取总大小
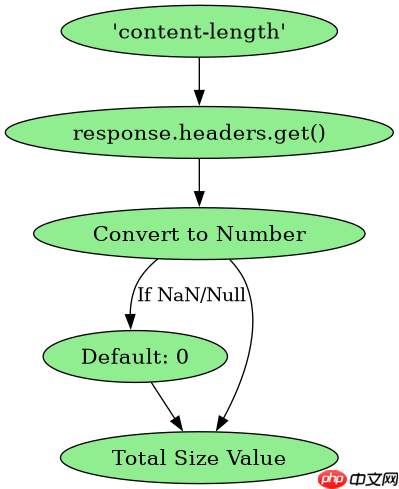
要计算下载进度,必须知道文件的总大小,这通常通过检查响应头中的 Content-Length 字段获得。如果服务器未提供该头部,则无法计算精确的百分比进度,只能显示“正在下载”。在代码实现中,首先发起 fetch 请求,然后从 response.headers 中读取 content-length(注意 HTTP 头部不区分大小写,但 JS 中通常用小写访问),将其转换为数字作为分母。
const response = await fetch('https://example.com/file.zip');
const contentLength = +response.headers.get('content-length') || 0;
console.log('Total size:', contentLength);
上述代码展示了如何安全地获取总大小。如果 content-length 不存在,默认值为 0,此时进度逻辑需特殊处理以避免除以零错误。获取到总大小后,即可在后续的数据块接收过程中进行累加计算。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何通过 ReadableStream 逐块读取数据
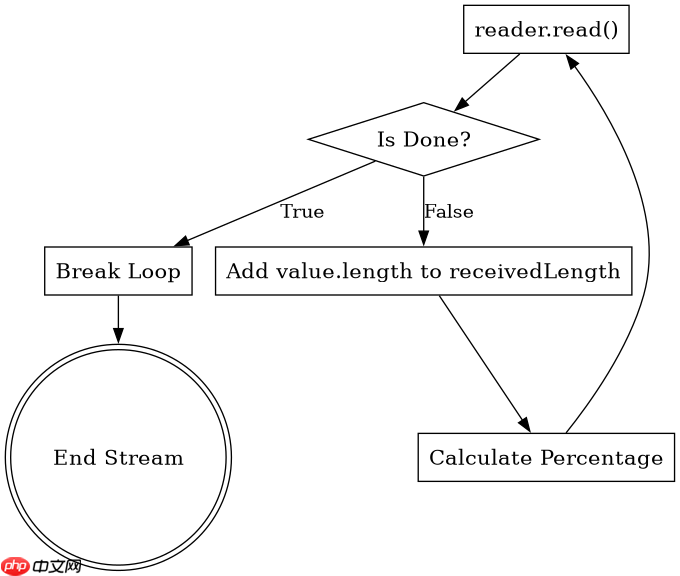
获取总大小后,下一步是实际读取数据流。使用 response.body.getReader() 创建一个 ReadableStreamDefaultReader 实例。通过一个 while 循环不断调用 reader.read(),该方法返回一个包含 value(当前块的二进制数据)和 done(布尔值,表示是否读完)的对象。每次成功读取一块数据后,将该块的长度累加到 receivedLength 变量中,并更新进度状态。
const reader = response.body.getReader();
let receivedLength = 0;

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  receivedLength += value.length;
  console.log(`Progress: ${(receivedLength / contentLength * 100).toFixed(2)}%`);
}
这段代码演示了基本的流式读取循环。在实际应用中,通常会将此逻辑封装在一个函数中,并通过回调或 Promise 链将进度信息传递给 UI 层。需要注意的是,value 是一个 Uint8Array,其 length 属性即为当前块的大小。当 done 为 true 时,循环终止,表示下载完成。
如何处理 Content-Length 缺失时的进度显示
在某些情况下,服务器可能不会返回 Content-Length 头部,例如使用了分块传输编码(Chunked Transfer Encoding)且未预知总大小的场景。此时,无法计算百分比进度。一种常见的处理方式是显示“未知进度”或使用旋转加载动画代替进度条。在代码中,可以在获取到 contentLength 为 0 时,跳过百分比计算,仅记录已接收字节数,或者向用户提示“进度不可用”。
if (contentLength === 0) {
  console.log('Progress unknown, total size not provided by server.');
  // Fallback to indeterminate progress bar or spinner
} else {
  // Calculate and display percentage as before
}
这种处理方式确保了应用在缺乏必要元数据时仍能正常运行,只是退化为非确定性的进度指示。开发者应根据业务需求决定是隐藏进度条还是显示其他状态。此外,对于大文件下载,建议结合断点续传机制,但这需要额外的服务端支持和客户端状态管理,超出了基础进度监控的范围。

















