








java jdbc 处理批量操作事务的标准做法是关闭自动提交模式,将 connection 设为手动管理,通过 addbatch() 累积 sql 语句,并在确认无误后调用 executebatch() 统一执行。若执行过程中发生异常,需立即捕获并调用 rollback() 回滚所有已变更的数据,确保原子性;若全部成功,则显式调用 commit() 提交事务。

JDBC 批量插入如何保证数据一致性
要保证批量插入的一致性,核心在于禁用 autoCommit 并使用 try-catch-finally 结构包裹执行逻辑。在 finally 块中必须检查连接状态,若未提交则强制回滚,防止因程序意外终止导致数据处于中间状态。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class BatchTransactionExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        // 使用 try-with-resources 自动关闭连接
        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                // 2. 添加批量数据
                for (int i = 0; i < 1000; i++) {
                    pstmt.setString(1, "User_" + i);
                    pstmt.setString(2, "user_" + i + "@example.com");
                    pstmt.addBatch();
                }

                // 3. 执行批量操作
                int[] results = pstmt.executeBatch();

                // 4. 提交事务
                conn.commit();
                System.out.println("Batch insert completed successfully.");
            } catch (SQLException e) {
                // 5. 发生异常时回滚
                try {
                    if (conn != null) {
                        conn.rollback();
                        System.err.println("Transaction rolled back due to error.");
                    }
                } catch (SQLException ex) {
                    ex.printStackTrace();
                }
                throw e;
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了标准的 JDBC 批量事务流程。首先通过 setAutoCommit(false) 开启事务控制。接着在循环中使用 addBatch() 将多条插入语句加入队列,这比逐条执行效率高得多。当所有数据准备就绪后,executeBatch() 一次性发送给数据库。如果这一步抛出 SQLException,说明部分或全部数据写入失败,此时进入 catch 块执行 rollback(),撤销之前所有的更改。只有当 executeBatch() 正常返回且无异常时,才调用 commit() 使更改永久生效。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
大批量数据如何处理以避免内存溢出
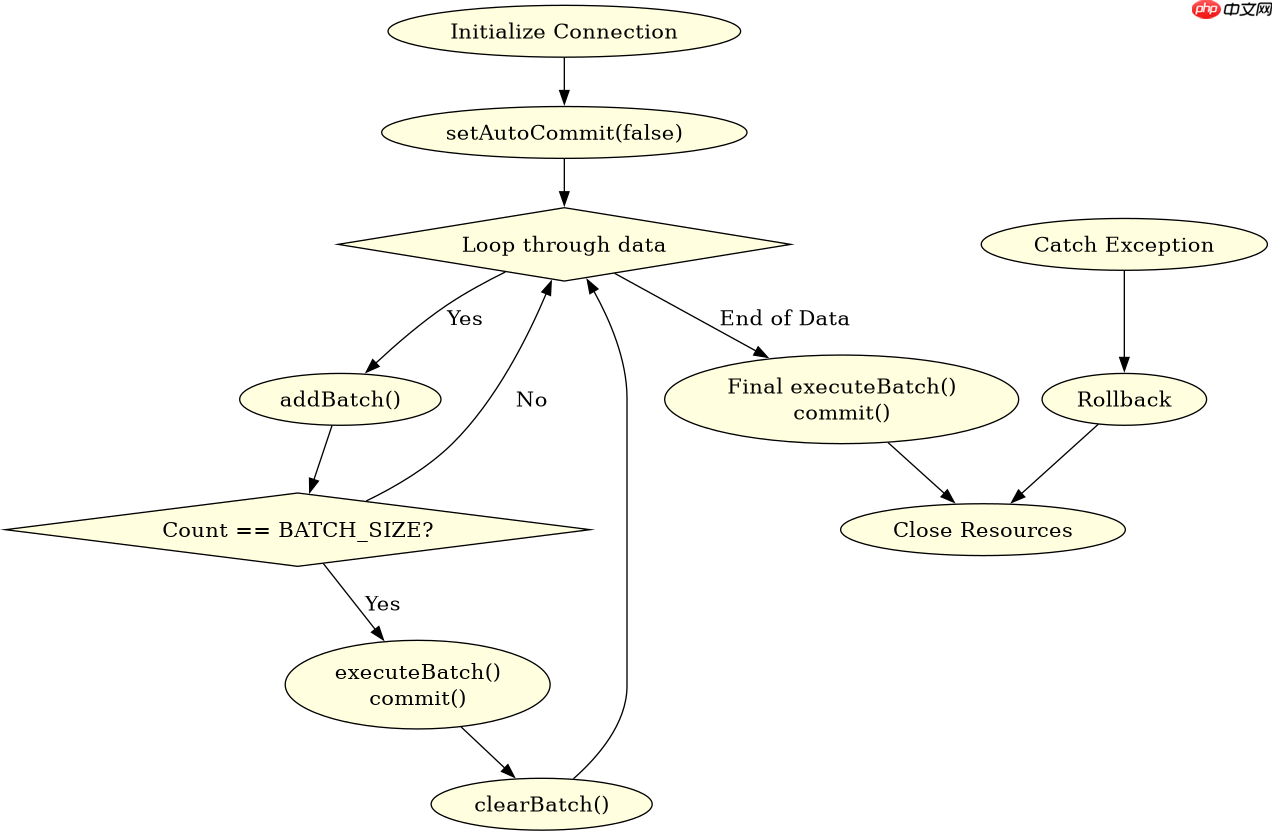
当批量数据量极大(如数万条以上)时,一次性将所有数据加入 Batch 会导致 JVM 内存溢出(OOM)。标准做法是分片处理,即设置一个固定的批次大小(如 500 或 1000),每积累满一批就执行一次 executeBatch() 和 commit(),然后清空批次继续下一轮。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class ChunkedBatchExample {
    private static final int BATCH_SIZE = 500;

    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO logs (message, timestamp) VALUES (?, ?)";

            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < 10000; i++) {
                    pstmt.setString(1, "Log message " + i);
                    pstmt.setLong(2, System.currentTimeMillis());
                    pstmt.addBatch();

                    // 每达到 BATCH_SIZE 次执行一次并提交
                    if ((i + 1) % BATCH_SIZE == 0) {
                        pstmt.executeBatch();
                        conn.commit();
                        pstmt.clearBatch(); // 清空批次,释放内存
                    }
                }

                // 处理剩余不足 BATCH_SIZE 的数据
                int[] remainingResults = pstmt.executeBatch();
                conn.commit();
                System.out.println("Chunked batch processing finished.");
            } catch (SQLException e) {
                conn.rollback();
                e.printStackTrace();
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
这种分片策略有效控制了单次事务中的内存占用。在循环内部,当计数器 i 达到 BATCH_SIZE 的倍数时,触发 executeBatch() 将当前批次的 SQL 发送到数据库。随后立即调用 commit() 提交这部分数据,使其成为持久化记录。紧接着调用 pstmt.clearBatch() 清除 PreparedStatement 内部的缓存,为下一批数据腾出空间。循环结束后,还需再次检查是否有余数数据需要执行,确保所有记录都被处理。这种方式虽然增加了多次提交的操作,但极大地提升了系统的稳定性和可扩展性。
executeBatch() 返回的 int[] 数组代表什么含义
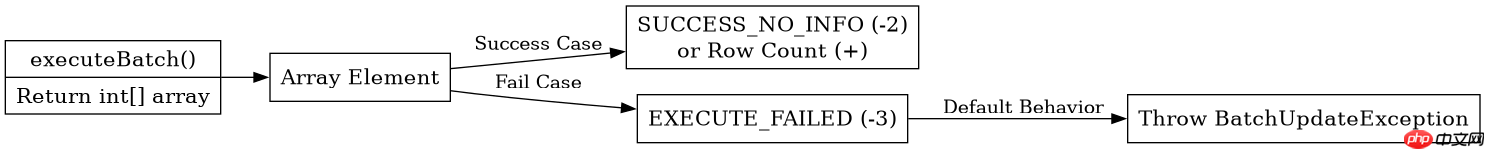
executeBatch() 方法返回一个 int[] 数组,数组中的每个元素对应本次批量操作中一条 SQL 语句的执行结果。如果某条语句执行成功,数组对应位置的值通常为 Statement.SUCCESS_NO_INFO(值为 -2)或受影响的行数(正值)。如果某条语句执行失败,对应位置的值通常为 Statement.EXECUTE_FAILED(值为 -3)。
在实际开发中,通常不依赖返回值的具体数值来判断单条语句的成功与否,而是通过捕获异常来处理整体失败的情况。因为 JDBC 规范规定,默认情况下只要有一条语句失败,整个批量操作就会抛出 BatchUpdateException,导致后续语句不再执行。如果需要更细粒度的控制,可以配置 continueOnError 属性,但这并非所有驱动都支持。因此,最稳妥的做法依然是依靠异常机制来保证数据的完整性,而不是解析返回数组。


















