








java nio 中 charbuffer 的使用核心在于通过 allocate() 或 wrap() 创建缓冲区,并利用 put() 写入数据、flip() 切换读写模式以及 get() 读取数据。调用 allocate(capacity) 会在堆内存中分配指定大小的连续空间并返回一个可写的缓冲对象;随后向其中填充字符后必须调用 flip() 将 limit 设为当前 position 并将 position 重置为 0,这样后续的读取操作才能正确限制在已写入的数据范围内。
CharBuffer 的创建方式有哪些区别
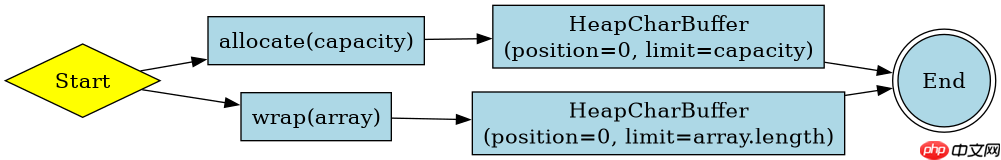
创建 CharBuffer 主要有两种途径:使用 allocate(int capacity) 在堆上分配新数组,或使用 wrap(char[] array) 包装现有数组。前者适用于需要独立存储且大小固定的场景,后者适用于复用已有数据或避免额外内存分配的场景。两者返回的都是 HeapCharBuffer 实例,但底层支持的数组不同,且 wrap 方法允许指定起始偏移量和长度,从而截取部分数组内容。
import java.nio.CharBuffer;

public class CreateDemo {
    public static void main(String[] args) {
        // 方式一:分配固定容量的堆缓冲区
        CharBuffer buf1 = CharBuffer.allocate(10);
        System.out.println("Allocated: capacity=" + buf1.capacity() + ", limit=" + buf1.limit());

        // 方式二:包装现有字符数组
        char[] data = {'A', 'B', 'C'};
        CharBuffer buf2 = CharBuffer.wrap(data);
        System.out.println("Wrapped: capacity=" + buf2.capacity() + ", limit=" + buf2.limit());

        // 方式三:包装数组的子集
        CharBuffer buf3 = CharBuffer.wrap(data, 1, 2); // 从索引1开始,取2个字符
        System.out.println("Sub-wrapped: capacity=" + buf3.capacity() + ", limit=" + buf3.limit());
    }
}
运行上述代码会输出:
Allocated: capacity=10, limit=10
Wrapped: capacity=3, limit=3
Sub-wrapped: capacity=2, limit=2
这表明 allocate 创建的缓冲区初始 limit 等于容量,而 wrap 创建的缓冲区 limit 等于被包装数组的有效长度(或子集长度),且 position 均为 0。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何正确执行读写切换与数据获取
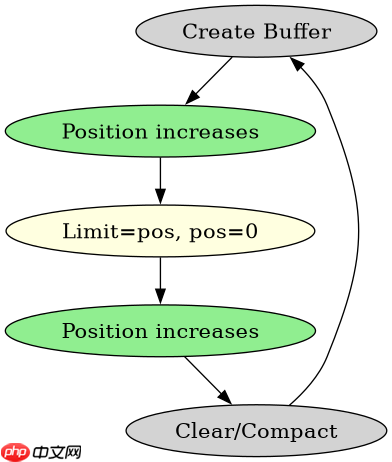
在向 CharBuffer 写入数据后,必须调用 flip() 方法才能开始读取。这是因为写入操作会递增 position,而读取操作从 position 开始直到 limit。如果不进行翻转,position 将位于末尾,导致无法读取任何数据。flip() 会将 limit 设置为当前的 position,并将 position 重置为 0,同时保留 mark(如果已设置)。读取完成后,如果需要再次写入,可以调用 clear() 重置所有标记位,或者调用 compact() 将未读数据移到缓冲区开头。
import java.nio.CharBuffer;

public class ReadWriteDemo {
    public static void main(String[] args) {
        CharBuffer buffer = CharBuffer.allocate(8);

        // 写入数据
        buffer.put('H');
        buffer.put('e');
        buffer.put('l');
        buffer.put('l');
        buffer.put('o');
        System.out.println("After put: position=" + buffer.position() + ", limit=" + buffer.limit());

        // 切换为读取模式
        buffer.flip();
        System.out.println("After flip: position=" + buffer.position() + ", limit=" + buffer.limit());

        // 读取数据
        while (buffer.hasRemaining()) {
            System.out.print(buffer.get());
        }
        System.out.println();

        // 清理缓冲区以便再次使用
        buffer.clear();
        System.out.println("After clear: position=" + buffer.position() + ", limit=" + buffer.limit());
    }
}
运行结果将打印 "Hello",并在控制台显示各阶段的位置和限制值。关键在于 flip() 后的 hasRemaining() 检查确保只读取已写入的部分,而 clear() 则完全重置缓冲区状态,使其回到初始可写状态。
CharBuffer 在重复模式下行为有何特殊之处
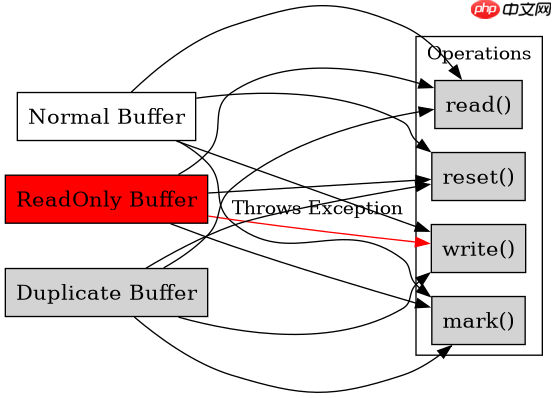
当调用 asReadOnlyBuffer() 或手动设置只读标志时,CharBuffer 可能进入只读模式,但更常见的是通过 duplicate() 创建的副本共享原缓冲区的数据区域。然而,真正影响行为的是 mark() 和 reset() 机制。如果在读取过程中调用了 mark(),之后可以通过 reset() 将 position 返回到标记位置。此外,如果缓冲区是只读的(例如通过 asReadOnlyBuffer() 获得),任何试图修改其内容的操作都会抛出 ReadOnlyBufferException。这种特性在需要从同一数据源生成多个视图但不希望意外修改原始数据时非常有用。


















