








使用xorm的groupby进行分组统计,核心方法是调用table()指定表名后链式调用groupby()设置分组字段,并配合find()将结果映射到结构体。由于xorm底层依赖sql标准,聚合函数(如count、sum)必须通过cols()或select()显式声明,否则查询可能因only_full_group_by模式报错或返回空值。执行后,未包含在聚合函数中的字段会按分组键去重,而聚合结果需手动解析。

如何正确编写带聚合函数的GroupBy查询语句
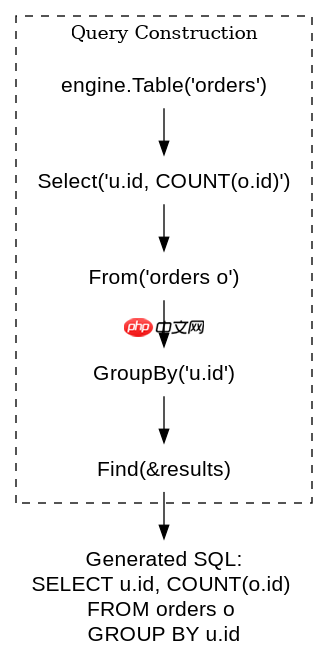
要获取分组后的统计数据,必须在查询构建器中明确指定聚合列。如果只传分组字段而不传聚合字段,XORM生成的SQL可能不符合严格模式要求。正确的做法是将聚合函数作为Cols()的参数传入,这样XORM才能生成类似SELECT user_id, COUNT(*) FROM orders GROUP BY user_id的有效语句。
package main

import (
    "fmt"
    "github.com/go-xorm/xorm"
    _ "github.com/mattn/go-sqlite3"
)

type Order struct {
    ID     int64  `xorm:"pk autoincr"`
    UserID int64  `xorm:"user_id"`
    Amount float64 `xorm:"amount"`
}

type GroupResult struct {
    UserID int64   `xorm:"user_id"`
    Count  int64   `xorm:"count"`
    Total  float64 `xorm:"total_amount"`
}

func main() {
    engine, _ := xorm.NewEngine("sqlite3", "test.db")

    // 构造查询:按UserID分组,统计订单数和总金额
    results := make([]GroupResult, 0)
    err := engine.Table("orders").
        Select("o.user_id, COUNT(o.id) as count, SUM(o.amount) as total_amount").
        From("orders o").
        GroupBy("o.user_id").
        Find(&results)

    if err != nil {
        fmt.Println("Error:", err)
        return
    }
    for _, r := range results {
        fmt.Printf("User: %d, Count: %d, Total: %.2f\n", r.UserID, r.Count, r.Total)
    }
}
上述代码中,Select方法定义了输出列,From指定了源表别名,GroupBy指定了分组依据。运行后,results切片将包含每个用户的统计信息。注意结构体标签必须与SQL中的别名一致,以便XORM正确映射数据。
GroupBy查询中如何处理NULL值和默认聚合行为
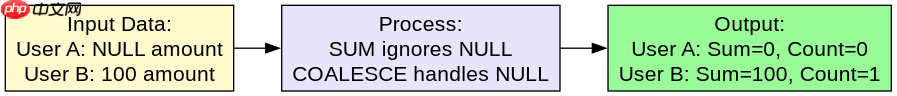
当分组字段存在NULL值时,XORM会将所有NULL视为同一组进行聚合。对于没有数据的分组,聚合函数如COUNT返回0,而SUM或AVG可能返回NULL或0,具体取决于数据库驱动和SQL方言。若需确保数值型结果为0而非NULL,应在SQL中使用COALESCE或IFNULL包裹聚合函数。
// 修改Select部分以处理NULL
Select("o.user_id, COUNT(o.id) as count, COALESCE(SUM(o.amount), 0) as total_amount")
// 或者在Go代码中处理
for _, r := range results {
    if r.Total == 0 && r.Count == 0 {
        continue // 跳过无数据用户
    }
}
在实际应用中,建议先在SQL层处理NULL转换,避免在Go代码中进行繁琐的类型断言和零值检查。此外,若分组条件复杂,可结合Where子句过滤后再分组,以减少无效数据的传输和处理开销。
基于Orders表中Amount字段的分组统计结果分析
在Orders表中,若按User_ID分组统计Amount,结果集将按用户ID排序(取决于数据库实现),每个用户对应一行记录。若某用户无订单,则不会出现在结果集中;若有订单但金额为NULL,SUM将忽略该值。最终输出的Total字段为该用户所有非空金额的总和,Count为有效订单数。此行为适用于大多数关系型数据库,但在MySQL 5.7+或PostgreSQL中需确保ONLY_FULL_GROUP_BY已启用,否则可能返回非确定性结果。




















