








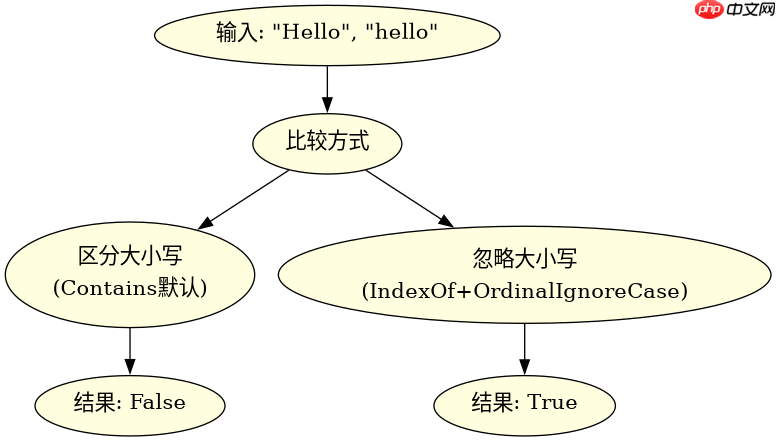
在旧版.net中,string.contains方法本身不支持忽略大小写的参数,必须改用indexof方法并传入stringcomparison.ordinalignorecase枚举值来实现。具体做法是将str.contains(sub)替换为str.indexof(sub, stringcomparison.ordinalignorecase) >= 0,这样即可在不区分大小写的情况下判断子串是否存在。

IndexOf如何替代Contains实现不区分大小写检查
使用IndexOf配合StringComparison.OrdinalIgnoreCase是处理此问题的标准方案。该方法返回子串首次出现的索引,若未找到则返回-1,因此通过判断返回值是否大于等于0即可模拟Contains的布尔行为。
using System;

class Program
{
    static void Main()
    {
        string text = "Hello World";
        string sub = "world";

        // 错误写法:默认区分大小写,返回 false
        bool containsDefault = text.Contains(sub);
        Console.WriteLine(containsDefault);

        // 正确写法:忽略大小写,返回 true
        bool containsIgnoreCase = text.IndexOf(sub, StringComparison.OrdinalIgnoreCase) >= 0;
        Console.WriteLine(containsIgnoreCase);
    }
}
预期输出:
False
True

不同StringComparison选项对性能的影响
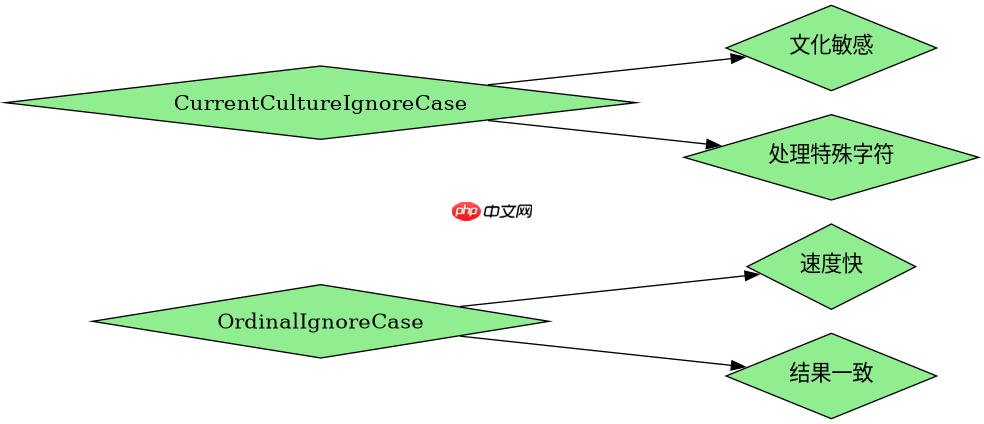
除了OrdinalIgnoreCase,还可以使用CurrentCultureIgnoreCase进行基于当前文化的不区分大小写比较。前者基于二进制码点比较,速度更快且结果一致;后者考虑语言习惯(如土耳其语的特殊规则),速度稍慢但更符合用户直觉。
using System;

class Program
{
    static void Main()
    {
        string text = "İstanbul"; // 包含土耳其语大写字母 I
        string sub = "istanbul";

        // OrdinalIgnoreCase: 基于Unicode码点,可能不匹配
        bool ordinal = text.IndexOf(sub, StringComparison.OrdinalIgnoreCase) >= 0;
        Console.WriteLine(ordinal);

        // CurrentCultureIgnoreCase: 基于当前文化,通常能匹配
        bool culture = text.IndexOf(sub, StringComparison.CurrentCultureIgnoreCase) >= 0;
        Console.WriteLine(culture);
    }
}预期输出取决于系统区域设置,但在大多数非土耳其语环境下,OrdinalIgnoreCase可能返回False而CurrentCultureIgnoreCase返回True。
当输入字符串为null时会发生什么
如果调用IndexOf的对象或参数为null,将抛出NullReferenceException。这与Contains的行为一致,因此在实际代码中应先检查空值或使用string.IsNullOrEmpty进行防护。
















