








通过配置 performance_schema 的 setup_instruments 和 setup_consumers,开启 sql 语句采集并写入 events_statements_summary_by_digest 表,即可定位 php 应用中的慢语句。具体做法是启用 statement/sql/select 等 instrument,确保 events_statements_current 和 events_statements_history_long consumer 处于 enabled 状态,随后查询 sum_timer_wait 或 count_star 最高的记录。
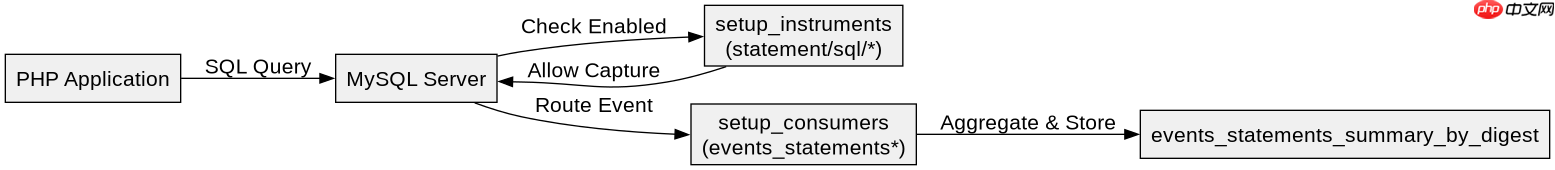
如何开启 MySQL 端的性能数据采集?
在 MySQL 服务端直接修改配置以激活对 SQL 语句的监控。需要更新 setup_instruments 表,将涉及 SQL 执行的 Instrument 设为 ENABLED,同时检查 setup_consumers 表,确保用于存储历史数据的 Consumer 已开启。这一步骤不依赖 PHP 代码改动,而是从数据库层面捕获所有经过的 SQL 请求。
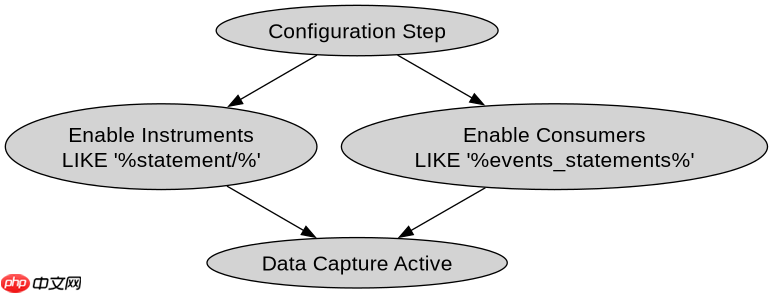
UPDATE performance_schema.setup_instruments SET ENABLED = 'YES' WHERE NAME LIKE '%statement/%';
UPDATE performance_schema.setup_consumers SET ENABLED = 'YES' WHERE NAME LIKE '%events_statements%';
执行上述 SQL 后,MySQL 开始实时收集语句执行信息。可以通过查询 performance_schema.events_statements_summary_by_digest 表来查看聚合后的数据。该表按 SQL 指纹(DIGEST)分组,记录了执行次数、总耗时、平均耗时等关键指标。对于 PHP 应用而言,这能屏蔽掉动态参数差异,聚焦于重复执行的慢查询模式。
立即学习“PHP免费学习笔记(深入)”;

如何从聚合表中筛选出真正的慢语句?
基于采集到的聚合数据,通过排序找出耗时最长或频率最高的 SQL 指纹。通常使用 SUM_TIMER_WAIT 作为主要排序依据,因为它反映了语句对系统资源的总体占用。同时结合 COUNT_STAR 判断是否为高频调用导致的累积慢响应。查询结果中的 DIGEST_TEXT 字段提供了脱敏后的 SQL 模板,便于开发者快速定位代码位置。

SELECT DIGEST_TEXT, COUNT_STAR, SUM_TIMER_WAIT, AVG_TIMER_WAIT
FROM performance_schema.events_statements_summary_by_digest
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 10;
运行此查询可得到 Top 10 慢语句列表。注意 TIMER_WAIT 的单位是皮秒(picoseconds),转换为毫秒需除以 10^9。若发现某条语句 COUNT_STAR 极高但单次耗时低,可能是 N+1 查询问题;若单次耗时高且计数少,则可能是缺少索引或锁等待。结合 PHP 日志中的 Trace ID 或时间戳,可进一步关联到具体的业务请求。
当遇到大量相似但参数不同的慢语句时如何处理?
如果 DIGEST_TEXT 显示为多个不同指纹,说明参数化不足或哈希算法未合并。此时应检查应用层是否使用了预编译语句(Prepared Statements)。PHP 中推荐使用 PDO 或 MySQLi 的预处理功能,确保相同结构的 SQL 被归一化为同一 DIGEST。此外,可调整 MySQL 8.0+ 的 performance_schema_digest_text_size 参数,防止长 SQL 被截断导致指纹不一致。


















