








cgroup内存限制为什么对109619也有效?和RLIMIT_AS差在哪?
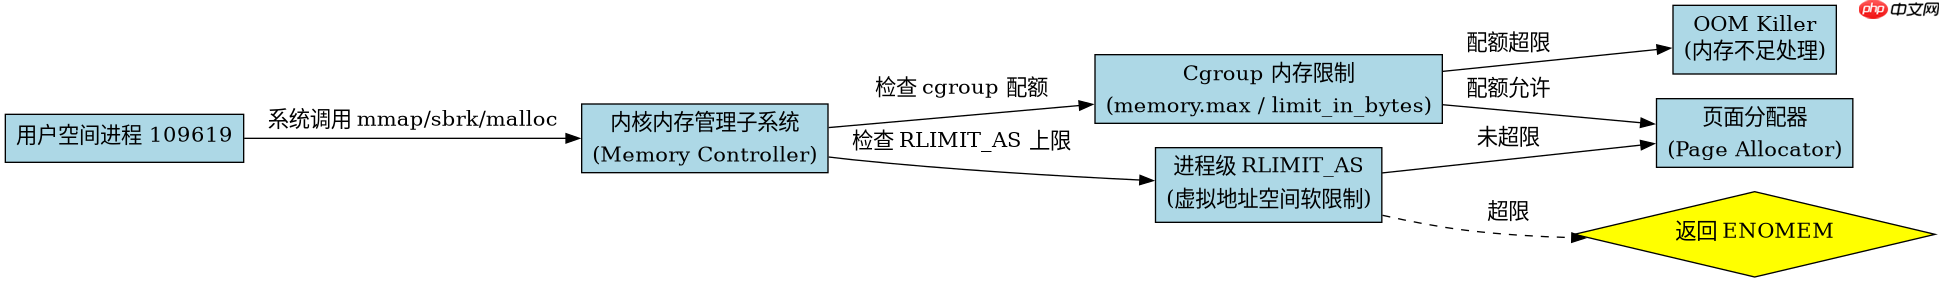
cgroup内存限制对进程109619有效,是因为该进程被调度器分配到了配置了内存上限的cgroup控制组中,内核的内存管理子系统(memory controller)会在其申请内存时强制执行限额检查。它与rlimit_as的核心区别在于作用范围和机制:cgroup是系统级的资源隔离与配额管理,针对的是整个控制组内所有进程的总和及各类内存指标(如rss、cache),由内核页面分配器介入;而rlimit_as是进程级的虚拟地址空间软限制,仅限制单个进程可寻址的总大小,不涉及物理页的实际回收或共享内存的统计。
如何验证进程109619所属的cgroup层级?
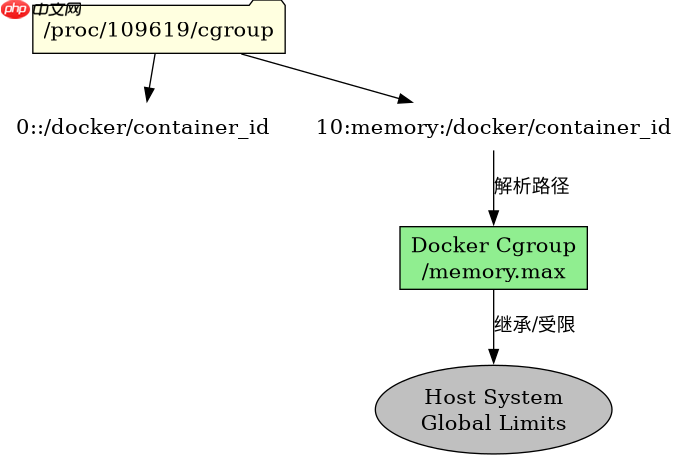
要确认进程109619受哪个cgroup限制,最直接的方法是读取其任务状态文件中的cgroup字段。在Linux系统中,每个进程目录下的/proc/[pid]/cgroup文件记录了该进程当前挂载的所有层级控制器及其对应的路径。通过解析这个文件,可以明确看到它属于哪个具体的内存控制组,进而关联到该组的memory.limit_in_bytes(对于cgroup v1)或memory.max(对于cgroup v2)设置值。
cat /proc/109619/cgroup
输出示例通常包含层级ID、控制器名称和路径,例如:0::/docker/abc123...
这表明进程位于根层级,且属于名为docker的cgroup v2层级下的特定容器路径。结合systemd-cgls或lxcfs提供的视图,可以更直观地看到该路径对应的资源限制数值。
RLIMIT_AS与cgroup在内存行为上的具体差异是什么?
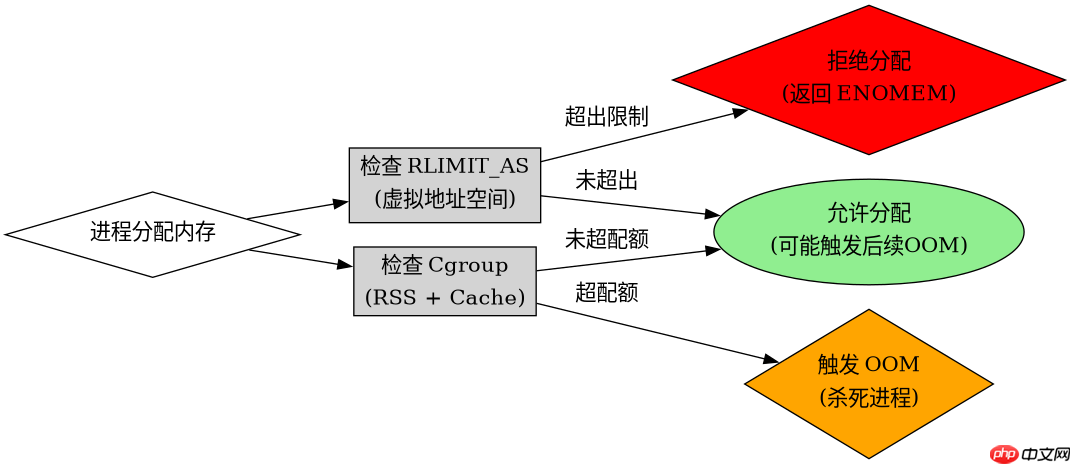
当进程尝试分配内存时,RLIMIT_AS和cgroup的处理逻辑截然不同。RLIMIT_AS主要拦截mmap和sbrk等系统调用,如果虚拟地址空间超过设定值,直接返回ENOMEM错误,进程无法继续扩展堆或映射区域。它不关心物理内存是否充足,只关心地址空间的“账面”大小。相比之下,cgroup的内存限制更为复杂,它不仅监控虚拟地址空间,更核心的是监控实际使用的物理内存(RSS)和页缓存(Cache)。即使RLIMIT_AS允许,如果进程在cgroup中触发了OOM(Out Of Memory),内核会触发内存回收机制,若回收失败则杀死进程或报告OOM事件。此外,cgroup可以统计共享内存和匿名页面的复用情况,而RLIMIT_AS对共享内存的处理往往取决于具体的实现细节和版本,通常不计入或单独计算,导致两者在并发场景下的表现差异巨大。
# 测试 RLIMIT_AS 限制
#include <sys/resource.h>
#include <stdio.h>
#include <stdlib.h>

int main() {
    struct rlimit rl;
    getrlimit(RLIMIT_AS, &rl);
    printf("Current RLIMIT_AS: %ld\n", rl.rlim_cur);

    // 尝试分配超过限制的内存
    void *ptr = malloc(1ULL * 1024 * 1024 * 1024); // 1GB
    if (ptr == NULL) {
        perror("malloc failed");
    } else {
        free(ptr);
    }
    return 0;
}上述代码展示了RLIMIT_AS的拦截行为。如果将rlim_cur设置为较小值,malloc将直接失败。而在cgroup环境中,同样的malloc可能成功,但如果后续访问这些内存导致物理页占用超过cgroup限制,才会触发后续的OOM保护机制。

















