








JDBC 批量操作事务保存点
java jdbc 处理批量操作事务保存点,核心是调用 connection.setsavepoint() 创建标记,并在发生异常时通过 connection.rollback(savepoint) 回滚到该标记。具体做法是在循环执行 addbatch() 和 executebatch() 的过程中,每处理完一批数据就设置一个保存点;如果某批数据抛出异常,捕获后回滚到上一个保存点,从而保留已成功提交的数据,实现断点续传或分批容错。

如何配置自动提交与手动事务
在使用保存点之前,必须将 Connection 的自动提交模式关闭(setAutoCommit(false)),否则所有 SQL 会立即生效,无法进行事务回滚。接着在代码中显式管理事务边界,确保 rollback 和 commit 能够正确作用于批量操作的上下文。
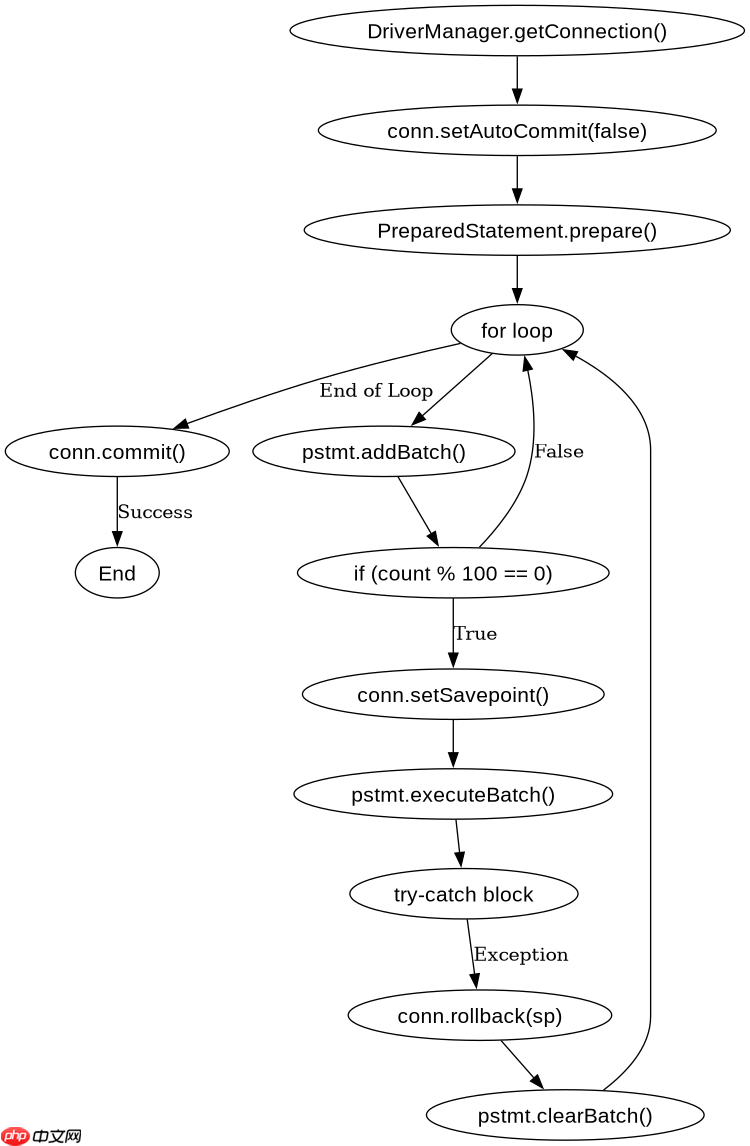

import java.sql.*;

public class BatchWithSavepoint {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                int batchSize = 100;
                int count = 0;
                Savepoint savepoint = null;

                for (int i = 0; i < 1000; i++) {
                    pstmt.setString(1, "User_" + i);
                    pstmt.setString(2, "user_" + i + "@example.com");
                    pstmt.addBatch();
                    count++;

                    // 每100条执行一次批量插入
                    if (count % batchSize == 0) {
                        try {
                            // 在执行前设置保存点
                            savepoint = conn.setSavepoint("batch_" + (i / batchSize));
                            pstmt.executeBatch();
                            System.out.println("Batch completed up to index: " + i);
                        } catch (BatchUpdateException e) {
                            // 2. 发生错误时回滚到保存点
                            if (savepoint != null) {
                                conn.rollback(savepoint);
                                System.err.println("Rolled back to savepoint after error at index: " + i);
                            }
                            // 继续下一批,不清除 pstmt 状态,因为 addBatch 是累积的
                            // 注意:某些驱动在 rollback 后可能需要重新 prepareStatement 或 clearBatch
                            pstmt.clearBatch();
                        }
                    }
                }
                // 执行剩余部分
                if (count % batchSize != 0) {
                    pstmt.executeBatch();
                }
                // 3. 全部成功后提交
                conn.commit();
            } catch (SQLException e) {
                conn.rollback();
                e.printStackTrace();
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
保存点失效或性能瓶颈的具体问题
在实际使用中,频繁创建保存点会导致数据库日志膨胀,降低批量插入的性能。此外,如果使用的数据库驱动不支持保存点(如某些旧版 MySQL 驱动或未开启事务隔离),setSavepoint 会抛出 SQLFeatureNotSupportedException。此时应改用更小的批次大小或分片处理,而不是依赖保存点机制。
立即学习“Java免费学习笔记(深入)”;

















