








在java中使用streamsupport.stream将lambda表达式与自定义spliterator结合,核心是调用重载方法传入spliterator实例和parallel标志。具体做法是先实现一个继承自abstractspliterator的类来定义tryadvance逻辑,然后在业务代码中通过streamsupport.stream(spliterator, false)生成串行流或true生成并行流,最后直接对生成的流进行map、filter等lambda操作。

如何构建支持Lambda操作的自定义Spliterator
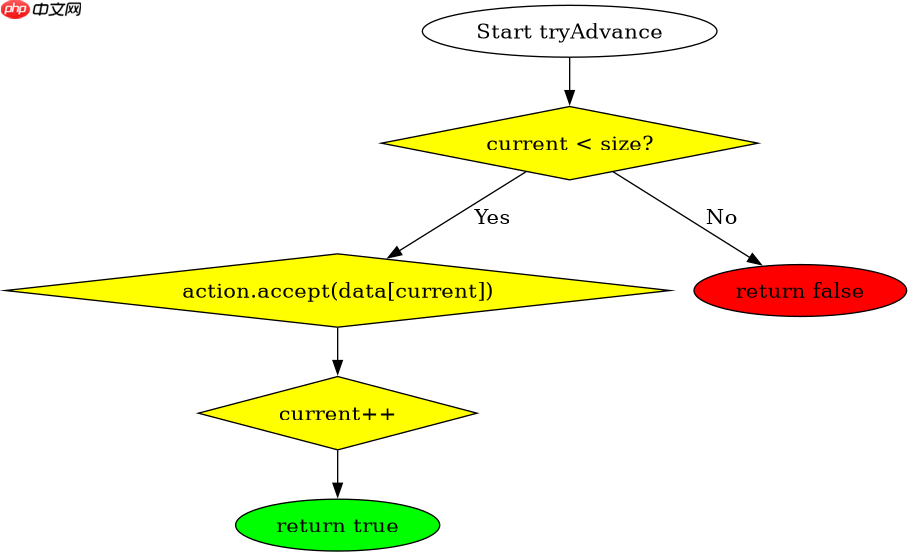
要使用Lambda处理非集合数据源,必须实现java.util.Spliterator接口。通常的做法是继承AbstractSpliterator并实现tryAdvance方法,该方法接收一个Consumer
import java.util.Spliterator;
import java.util.function.Consumer;

public class CustomSpliterator<T> implements Spliterator<T> {
    private int current = 0;
    private final int size;
    private final T[] data;

    public CustomSpliterator(T[] data) {
        this.data = data;
        this.size = data.length;
    }

    @Override
    public boolean tryAdvance(Consumer<? super T> action) {
        if (current < size) {
            action.accept(data[current++]);
            return true;
        }
        return false;
    }

    @Override
    public Spliterator<T> trySplit() {
        if (current >= size / 2) return null;
        int half = size / 2;
        int splitFrom = Math.max(current, half);
        // 简化示例:实际需创建新实例并调整范围
        return new CustomSpliterator<>(data);
    }

    @Override
    public long estimateSize() { return size - current; }

    @Override
    public int characteristics() { return ORDERED | SIZED | SUBSETTED; }
}
如何在StreamSupport中配置并行与串行模式
StreamSupport.stream有两个主要重载版本,区别在于第二个boolean参数parallel。当该参数为false时,生成的流是串行的,Lambda操作按顺序执行;当为true时,生成的流是并行的,Spliterator会被拆分并在多线程中执行Lambda。选择哪种模式取决于数据量大小和Lambda操作的无状态性。对于CPU密集型且无共享状态修改的操作,设置为true可以利用多核优势加速处理。

立即学习“Java免费学习笔记(深入)”;

import java.util.stream.Stream;
import java.util.stream.StreamSupport;

public class Main {
    public static void main(String[] args) {
        String[] data = {"A", "B", "C", "D", "E"};
        CustomSpliterator<String> spliterator = new CustomSpliterator<>(data);

        // 串行模式
        Stream<String> serialStream = StreamSupport.stream(spliterator, false);
        serialStream.forEach(System.out::println);

        // 并行模式
        CustomSpliterator<String> spliterator2 = new CustomSpliterator<>(data);
        Stream<String> parallelStream = StreamSupport.stream(spliterator2, true);
        parallelStream.forEach(System.out::println);
    }
}
当Spliterator的trySplit返回null时会发生什么
当自定义Spliterator的trySplit方法返回null时,意味着该Spliterator无法被进一步拆分。在并行流(parallel=true)的场景下,如果底层Spliterator无法拆分,Stream框架将无法把任务分配给多个线程,此时并行流会自动退化为串行流执行。这意味着即使你设置了parallel为true,如果数据源不支持分割(例如某些只读列表或特定实现的Spliterator),Lambda表达式的执行依然会是单线程顺序执行的,不会获得并行处理的性能提升。


















