








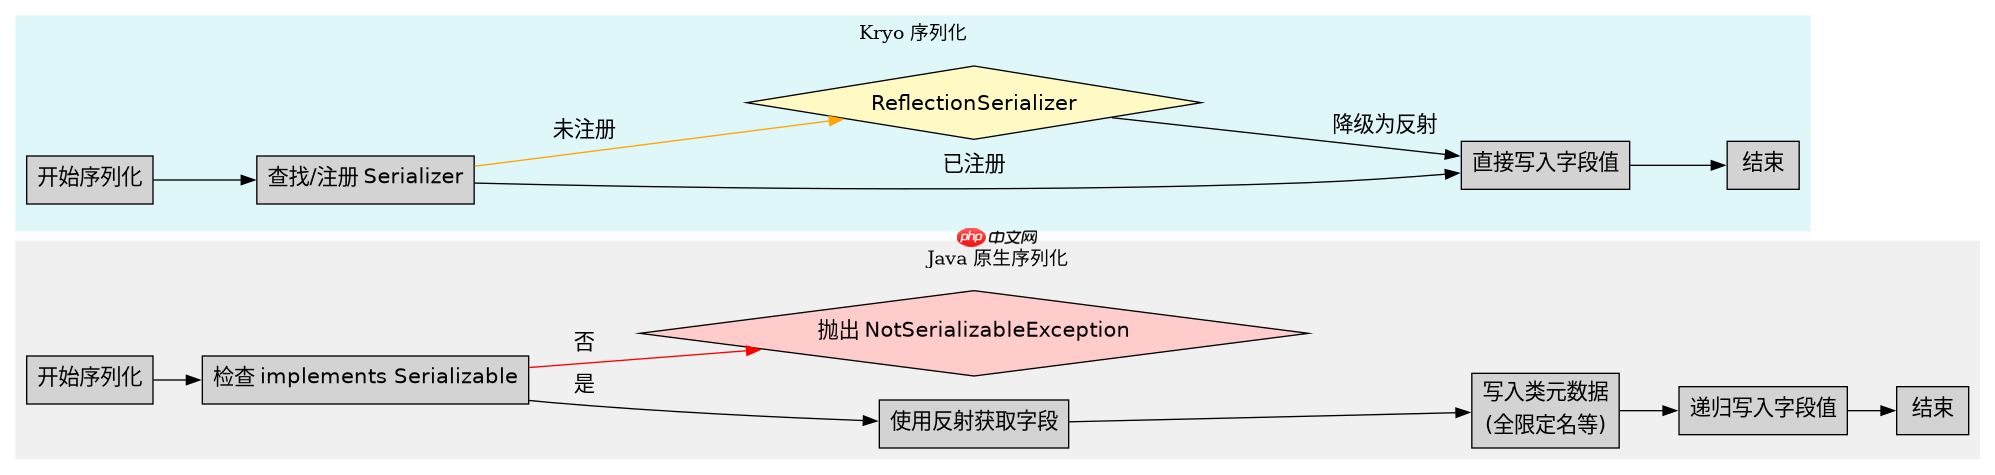
kryo 和 java 原生序列化在核心机制、性能表现和适用场景上存在显著差异。java 序列化基于反射和对象图遍历,生成包含类元数据的冗长二进制流,兼容性强但速度慢且体积大;kryo 则采用动态字节码生成或预注册策略,直接读写字段值,速度极快且体积小,但牺牲了部分跨语言兼容性。选择 kryo 通常是为了追求高性能的内部系统通信,而 java 序列化更适合需要长期存储或跨 jvm 版本兼容的场景。
Kryo 如何通过注册机制提升序列化速度
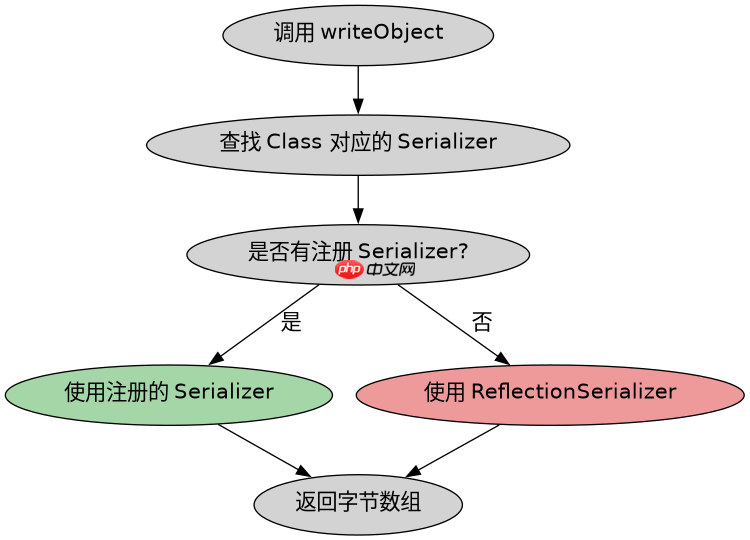
Kryo 通过注册序列化器(Serializer)来避免每次序列化时都进行反射查找,从而大幅提升速度。默认情况下,Kryo 会使用 ReflectionSerializer,但这与 Java 序列化类似,性能较差。开发者可以通过调用 register() 方法为特定类指定高效的序列化器,或者使用 kryo-annotations 库配合注解自动生成序列化逻辑。这种机制使得 Kryo 在处理大量相同类型对象时,能够跳过类名写入和反射开销,直接操作内存数据。
import com.esotericsoftware.kryo.Kryo;
import com.esotericsoftware.kryo.io.Input;
import com.esotericsoftware.kryo.io.Output;

public class KryoExample {
    public static void main(String[] args) {
        Kryo kryo = new Kryo();
        // 注册类以优化性能,避免反射开销
        kryo.register(User.class);

        User user = new User("Alice", 30);
        byte[] data = serialize(kryo, user);
        System.out.println("Serialized size: " + data.length + " bytes");

        User deserialized = deserialize(kryo, data);
        System.out.println("Deserialized: " + deserialized.getName());
    }

    private static byte[] serialize(Kryo kryo, Object object) {
        Output output = new Output(new java.io.ByteArrayOutputStream());
        kryo.writeObject(output, object);
        return output.toBytes();
    }

    private static User deserialize(Kryo kryo, byte[] data) {
        Input input = new Input(new java.io.ByteArrayInputStream(data));
        return kryo.readObject(input, User.class);
    }
}

class User implements java.io.Serializable {
    private String name;
    private int age;
    public User(String name, int age) { this.name = name; this.age = age; }
    public String getName() { return name; }
}
上述代码展示了 Kryo 的基本用法。关键点在于 kryo.register(User.class)。如果不注册,Kryo 会回退到反射模式,导致性能下降。注册后,Kryo 缓存了该类的序列化策略,后续序列化同一类对象时速度接近原生内存拷贝。输出结果中,序列化后的字节数组长度远小于 Java 原生序列化的结果,体现了其紧凑性。
立即学习“Java免费学习笔记(深入)”;

Java 原生序列化如何处理对象图循环引用
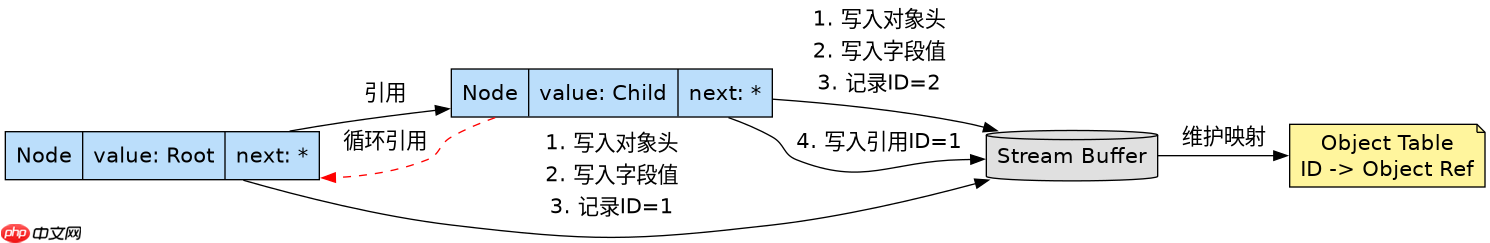
Java 原生序列化内置了对对象图循环引用的支持,这是其相对于许多轻量级序列化框架的主要优势之一。当两个对象相互引用形成环时,Java 序列化机制会通过维护一个已序列化对象的哈希表来识别重复引用,并写入一个特殊标记而非再次序列化整个对象。这使得开发者无需手动处理循环依赖即可正确保存和恢复复杂对象结构。相比之下,Kryo 默认也支持循环引用,但其内部实现依赖于不同的追踪机制,且在某些极端嵌套场景下可能需要更细致的配置以避免栈溢出。
import java.io.*;
import java.util.*;

public class JavaSerializationCycle {
    public static void main(String[] args) throws Exception {
        Node root = new Node("Root");
        Node child = new Node("Child");
        root.next = child;
        child.next = root; // 创建循环引用

        // 序列化
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        ObjectOutputStream oos = new ObjectOutputStream(baos);
        oos.writeObject(root);
        oos.close();
        byte[] data = baos.toByteArray();
        System.out.println("Java Serialized size: " + data.length + " bytes");

        // 反序列化
        ByteArrayInputStream bais = new ByteArrayInputStream(data);
        ObjectInputStream ois = new ObjectInputStream(bais);
        Node restored = (Node) ois.readObject();

        // 验证循环引用是否保留
        System.out.println("Restored root next is root? " + (restored.next == restored));
    }
}

class Node implements Serializable {
    String value;
    Node next;
    Node(String value) { this.value = value; }
}
这段代码演示了 Java 序列化如何处理循环引用。创建了两个互相指向的 Node 对象。序列化后,虽然对象图是环状的,但生成的字节流是线性的。反序列化后,restored.next == restored 为真,证明循环结构被完整保留。Java 序列化通过对象 ID 映射来实现这一点,确保每个唯一对象实例在流中只出现一次,后续引用仅指向该 ID。这种机制对开发者透明,无需额外代码即可处理复杂的图结构。
Kryo 在序列化非 Serializable 类时的行为差异
Kryo 不要求目标类实现 java.io.Serializable 接口,这使其能够序列化任何 Java 对象,包括第三方库中未实现该接口的类。只要该类有公共构造函数或可访问的字段,Kryo 就能通过反射或注册的序列化器进行处理。而 Java 原生序列化强制要求类实现 Serializable,否则会在运行时抛出 NotSerializableException。这一特性让 Kryo 在集成遗留系统或使用不可修改的第三方类时更加灵活,但也意味着开发者需要承担更多的兼容性责任,因为 Kryo 不会像 Java 序列化那样提供严格的版本控制检查。

















