








php拼接字符串出现乱码通常是因为参与拼接的字符串编码不一致,或者输出环境未声明正确的字符集。排查时,应使用`mb_detect_encoding()`确认各段文本的实际编码,并通过`mb_convert_encoding()`统一转换为utf-8后再进行拼接。若涉及数据库或文件读取,需确保连接层、存储层和传输层的编码设置一致,避免在中间环节发生隐式转换导致字节截断或错位。
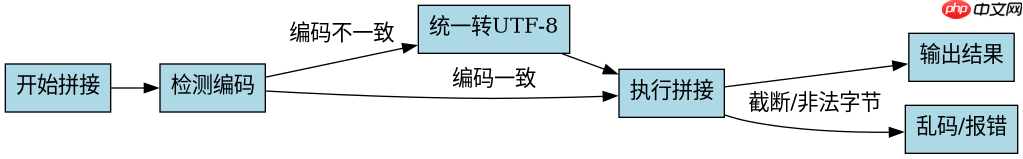
如何检测并统一多源字符串的编码格式
当从不同来源(如API、数据库、用户输入)获取数据时,直接拼接极易引发乱码。解决此问题的核心在于先识别每个字段的编码,再强制转换为统一的UTF-8。通过遍历数组或使用循环处理动态数据,可以批量修正编码问题,确保拼接前的数据一致性。
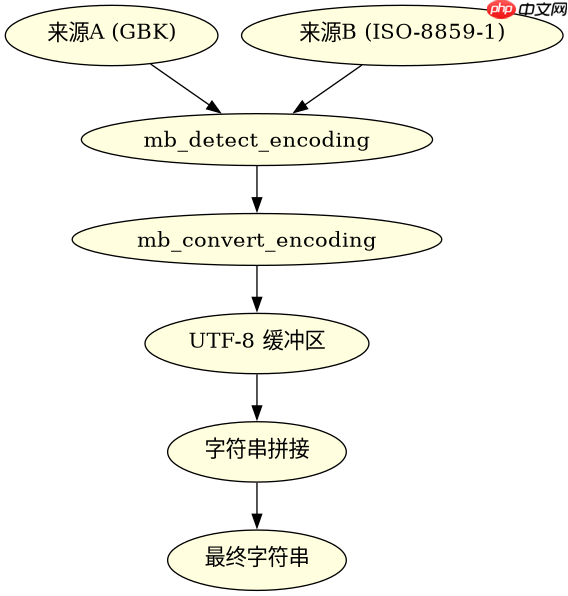
$data = [
    'name' => mb_convert_encoding($raw_name, 'UTF-8', 'GBK'),
    'desc' => mb_convert_encoding($raw_desc, 'UTF-8', 'ISO-8859-1')
];
$result = $data['name'] . $data['desc'];
echo mb_check_encoding($result, 'UTF-8');
数据库连接层编码不一致导致的乱码定位
即使代码中使用了正确的编码转换,如果数据库连接建立时未指定字符集,MySQL等数据库可能默认使用Latin1或其他编码,导致中文在存入或取出时被错误解释。定位此类问题需检查PDO或MySQLi的连接参数,显式设置charset为utf8mb4,并在SQL层面验证列的collation是否匹配。

立即学习“PHP免费学习笔记(深入)”;
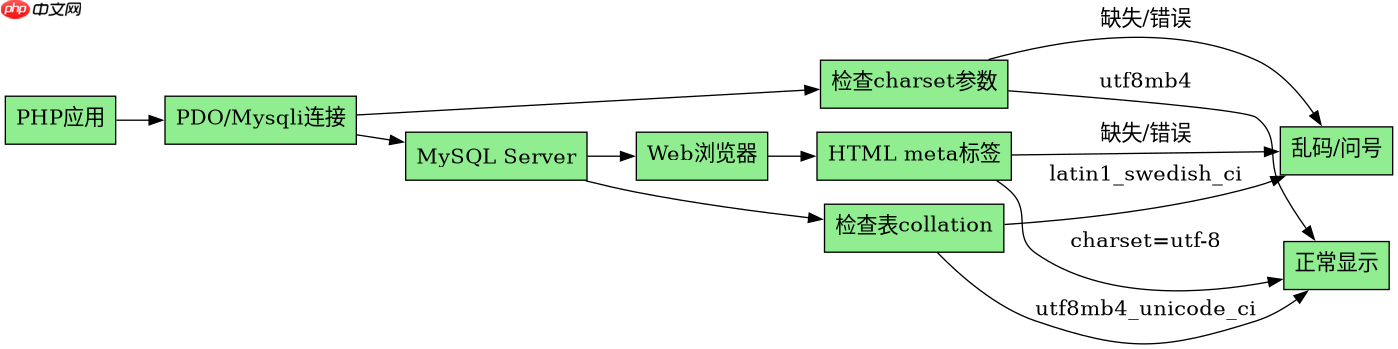
$pdo = new PDO('mysql:host=localhost;dbname=test;charset=utf8mb4', $user, $pass);
$stmt = $pdo->query("SELECT * FROM users WHERE name LIKE '%test%'");
$rows = $stmt->fetchAll(PDO::FETCH_ASSOC);
特定条件下拼接结果为何仍显示问号或替换字符
在某些极端情况下,即使编码看似正确,拼接后仍可能出现或?符号。这通常发生在多字节字符被意外截断,或者前端HTML未声明导致浏览器以默认编码解析。此外,若原始数据包含非法字节序列,`mb_convert_encoding`可能会将其替换为占位符。此时应检查输入数据的完整性,并确保输出头部设置了正确的Content-Type。















