





面对拥有64gb甚至更高内存的服务器,资源规划的核心不在于“填满”内存,而在于隔离与限制。许多管理员习惯将大内存视为万能缓冲,直接分配给虚拟机或容器,这往往导致系统级资源争用和不可预测的性能抖动。正确的做法是从硬件拓扑、软件边界和监控反馈三个维度进行硬性约束。
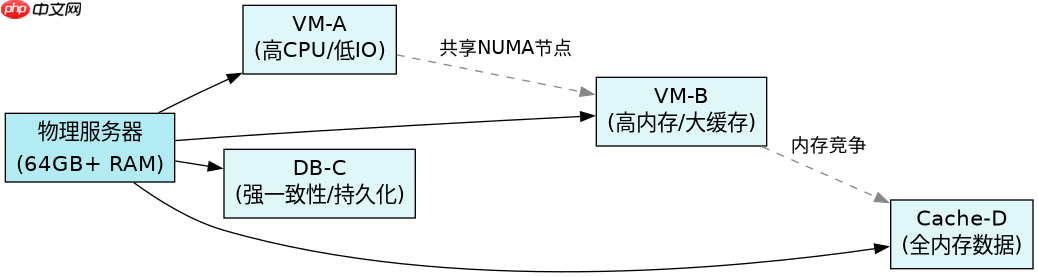
理解NUMA架构对内存分配的影响
在双路或多路服务器中,内存控制器通常与CPU插槽绑定,形成非统一内存访问(NUMA)结构。当进程访问本地节点内存时,延迟极低;若访问远程节点内存,需通过QPI/UPI总线,延迟显著增加。虚拟化环境中,若未正确绑定vCPU与物理核心,虚拟机会跨节点频繁迁移数据,造成性能断崖式下跌。
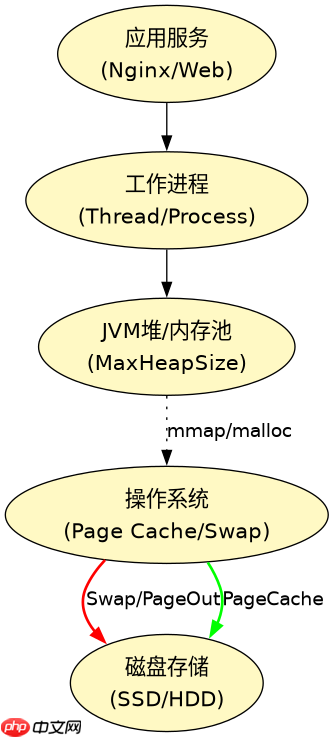
因此,规划的第一步是识别服务器的NUMA拓扑。使用numactl命令查看节点分布,并在部署关键应用时,强制其绑定到特定节点的CPU和内存上。对于数据库或缓存类应用,应确保其内存分配器优先从本地节点获取页面。同时,需警惕操作系统页缓存(Page Cache)对可用内存的隐性占用,它虽可提升磁盘IO,但在内存紧张时会成为首要被回收对象,影响应用稳定性。
实施内存硬限制与防OOM策略
仅靠软性建议无法防止内存泄漏或突发流量导致的系统崩溃。必须通过内核参数和容器引擎机制施加硬限制。Linux内核的OOM Killer机制会在内存耗尽时终止进程,但这可能导致服务中断。更优的策略是在应用层或容器层预先划定上限,避免触及内核阈值。
# 示例:在systemd服务文件中配置内存限制
[Unit]
Description=My High-Memory Application

[Service]
ExecStart=/usr/bin/myapp --config /etc/app.conf
# 限制最大虚拟地址空间为32GB,防止单进程无限增长
LimitAS=34359738368
# 限制物理内存使用量为24GB
MemoryLimit=25769803776

[Install]
WantedBy=multi-user.target
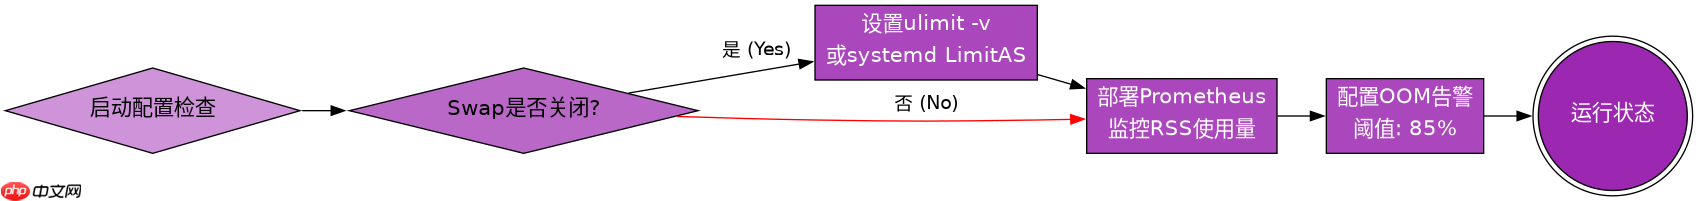
上述配置展示了如何在服务启动阶段即锁定资源上限。运行该服务前,需确认系统已禁用Swap或将其置于最低优先级,因为Swap的使用会掩盖真实的内存压力,导致性能劣化而非快速失败。配合Prometheus等监控工具,实时追踪RSS(常驻集大小)而非VSS(虚拟集大小),能更准确反映实际物理内存消耗。当RSS接近设定阈值时触发告警,运维人员可在OOM发生前介入扩容或重启,实现主动治理。
针对特定场景的容量预留计算
不同业务对内存的敏感度差异巨大。例如,Redis等全内存数据库要求预留至少20%的内存用于内部碎片管理和后台任务,而Web前端服务则可容忍较高的GC频率。在规划时,应基于历史峰值数据,结合业务SLA要求,确定每个实例的基线内存值。对于微服务架构,建议采用Kubernetes的Resource Requests和Limits字段,分别定义保证值和硬上限,确保集群在过载时仍能维持核心服务的可用性,而非整体雪崩。

















