





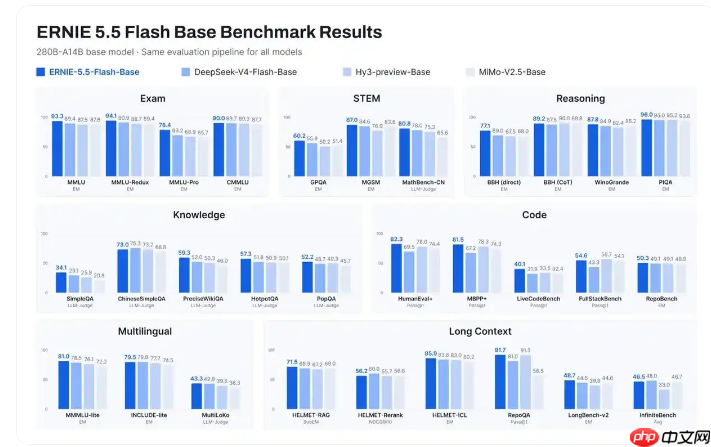
11月5日,百度正式对外开源其全新基座模型——文心5.5flash base。该模型在知识理解、逻辑推理、数学能力、代码生成、多语言支持及长上下文处理等多项权威基准测试中,均刷新了同参数量级模型的sota(state-of-the-art)成绩,性能表现优于deepseek-v4-flash-base、hy3-preview-base等同类竞品模型。
该模型基于MoE(Mixture of Experts)架构设计,总参数规模达2800亿,激活参数为140亿;预训练阶段使用高达33.5万亿Token的数据量,最大预训练上下文长度支持至128K;在微调与推理阶段,可稳定支持最长100万Token的上下文窗口。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

百度地图 RTOS SDK(mapsdk-rtos)应用层集成规范与代码生成。帮助应用开发者对接 mapsdk-rtos,开发类似 rtos-mac-simulator(mapAPP)的应用层,包含初始化鉴权、地图组件控制、覆盖物(Marker/Polyline)、检索路线、离线地图、导航、Canvas 适配层等能力。当用户提到:对接 RTOS 地图 SDK、集成 mapsdk-rtos、RTOS 地图初始化、MapComponentApi、AuthLicenseApi、SearchApi、NaviApi
围绕“效率”这一核心目标,文心5.5Flash Base在系统层面实施了多项关键算法创新:
- 在注意力机制方面,引入Latent-Gated Sparse Attention技术,融合HCA(Hierarchical Context Aggregation)与MLA(Multi-Level Attention)对历史信息进行高效压缩,并实现细粒度的历史位置访问;同时采用低秩门控注意力机制,使门控投影权重参数量降低75%;并通过虚拟头注意力(Virtual Head Attention)显著增强模型表达能力;
- 在专家路由策略上,提出Multi-Router Latent MoE方案,通过部署多个独立路由器提升专家选择的准确性与实用性;
- 在训练目标设计中集成ECHO(Efficient Contextual Head Optimization)机制,复用主干网络最后一层直接预测后续Token,无需额外引入MTP(Multi-Token Prediction)模块;
- 在大模型基础设施层面,优化分布式Muon优化器,并自主研发FlashMask-4注意力算子,在保障精度前提下大幅提升大规模训练过程中的通信效率与GPU显存利用率。
当前,大模型领域的竞争已从单一性能比拼,转向模型能力、训练效率与垂直场景创新的协同演进。文心5.5Flash Base的全面开源,不仅有效降低了专业级模型的研发门槛,更为广大开发者提供了构建高适配性、高性能定制化专业模型的坚实技术底座。




















