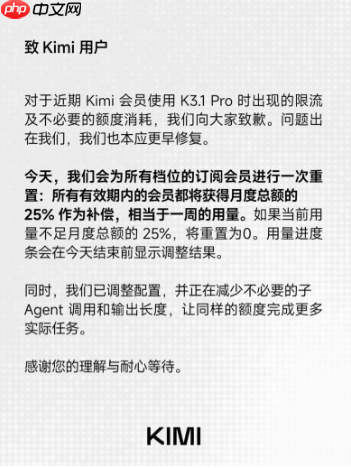
kimi 智能助手于今日(10 月 26 日)凌晨发布公开信,就近期会员在使用 k3.1 pro 模型过程中遭遇的不良体验正式致歉。问题主要集中在两个方面:其一,模型出现限流现象,高峰时段响应延迟明显、任务执行频频中断;其二,用户额度在未充分使用的情况下异常消耗,部分会员反映“ barely 开始用,额度就已见底”。官方明确承认责任在于自身,并表示本应更早识别并修复相关缺陷。
补救措施同步推出。平台将在今日内对所有订阅层级的会员执行统一额度重置:凡处于有效订阅期内的用户,均可获得当月总配额 25% 的额外补偿,折合约为一周用量;若用户当前已消耗额度不足该比例,则直接将已用额度清零。所有调整结果将于今日 24 点前同步至每位会员的用量看板,全程无需用户主动申请。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
严控非必要消耗

监控Kimi K2.5 API使用量和配额。通过Kimi控制台实现:(1)查看剩余使用百分比和重置计时器;(2)根据可用配额自主决策任务优先级;(3)密集操作前监控速率限制;(4)记录使用模式以支持资源规划。适用于配额约束下的自主智能体。
退还额度仅为短期应对,Kimi 已同步优化后端调度策略。据官方说明,系统已完成新一轮配置调优,重点压缩冗余子 Agent 调用频次,并精简输出内容长度,旨在提升单位额度的实际效能——直击此前用户反馈最强烈的“额度消失无踪”痛点。
回溯事件起点,争议源于两天前的新模型上线:10 月 24 日,月之暗面正式发布 K3.1 系列首秀模型——K3.1 Pro,这也是该公司迄今参数规模最大、能力最强的版本,参数量达 3 万亿级,支持最高约 100 万 token 的上下文窗口。新模型一经推出即引发大量用户集中接入,社交平台上迅速涌现关于响应卡顿、额度骤降的密集反馈,限流机制与计费逻辑随之成为焦点。今晨这封致歉信,既为降温舆论热度,也向整个高速演进的 AI 应用行业发出提醒:再强大的模型能力,若缺乏稳定的服务支撑与清晰透明的计费规则,用户体验终将打折扣。