


pdf转html过程中,最容易出问题的环节其实是文件上传、参数配置以及最终结果的校验。动手前务必先复制一份原始pdf作为备份,确认当前处理的是正确版本,再按以下步骤操作。
转换前请保留一份可回退的原始副本
正式开始转换前,建议先对源PDF进行备份,并再次核对文件版本号、总页数及核心内容范围是否准确无误。PDF转HTML表面看似一键完成,实则输出效果涉及网页布局结构、图片加载状态、超链接有效性、语义化段落层级以及响应式移动端适配等多个维度。文档越关键,越推荐使用备份副本先行试运行一次,防止因转换异常导致不可逆的数据丢失或格式错乱。
方法一:优先尝试 PDF.cn 在线平台
若目标是快速生成可在浏览器中直接预览与微调的网页版本,推荐首选PDF.cn在线服务(https://www.pdf.cn/)。该平台集成了多项常用文档处理功能,界面支持中文,无需注册即可使用。进入PDF转HTML模块后,上传待处理文件,依页面指引完成流程,下载完成后务必逐项检查排版还原度、图像显示完整性、链接跳转准确性、段落逻辑结构及移动设备浏览表现。
第1步:定位功能入口
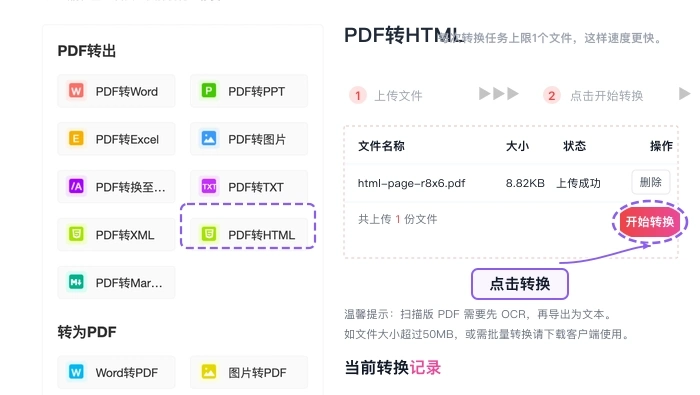
在工具导航栏中准确找到“PDF转HTML”功能项,注意区分名称相似的其他工具(如PDF压缩、PDF拆分、PDF转Word等),避免误操作。
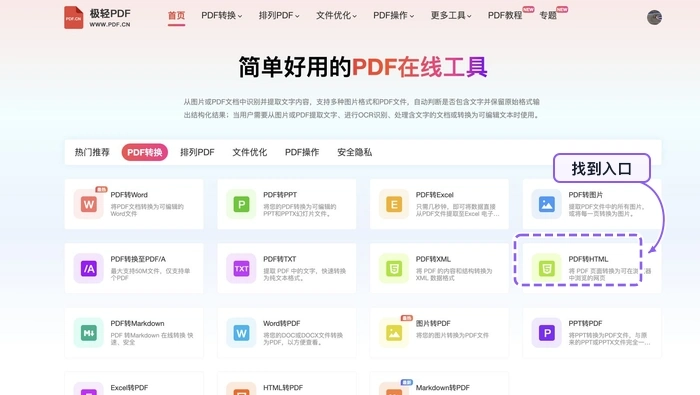
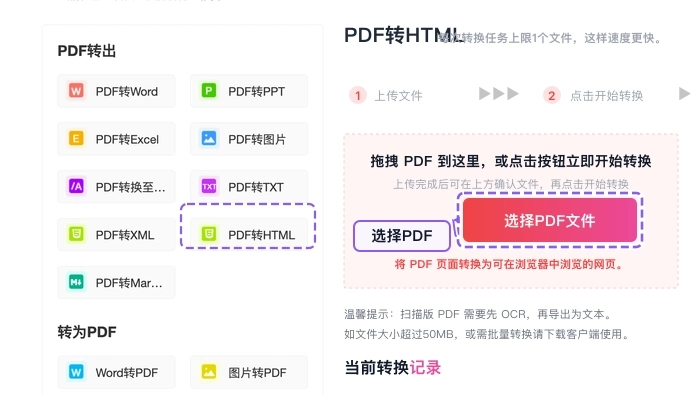
第2步:上传待转换文件
点击上传区域,从本地选取目标PDF文档。如文件体积较大,请耐心等待上传进度条走完,切勿重复点击上传按钮,否则可能引发上传中断或重复提交。
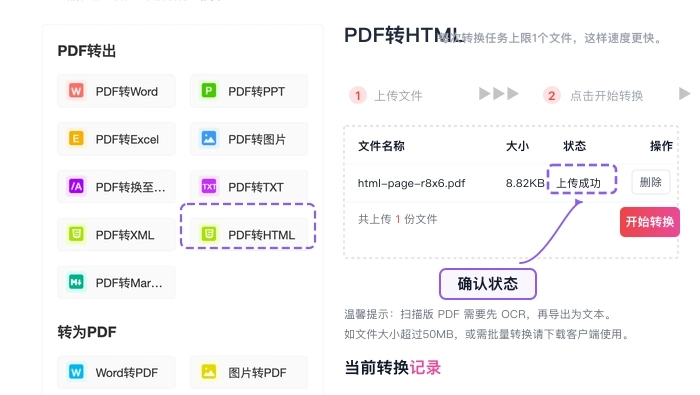
第3步:验证上传信息
上传完毕后,页面应清晰显示所选文件名、数量及大小。请仔细比对是否为预期文件,排除误传旧版或无关文档的可能性。
第4步:启动转换任务
确认所有选项设置无误后,点击“开始转换”按钮。转换期间请保持当前页面处于活跃状态,避免关闭或刷新,直至系统提示“转换完成”。
第5步:获取并保存结果
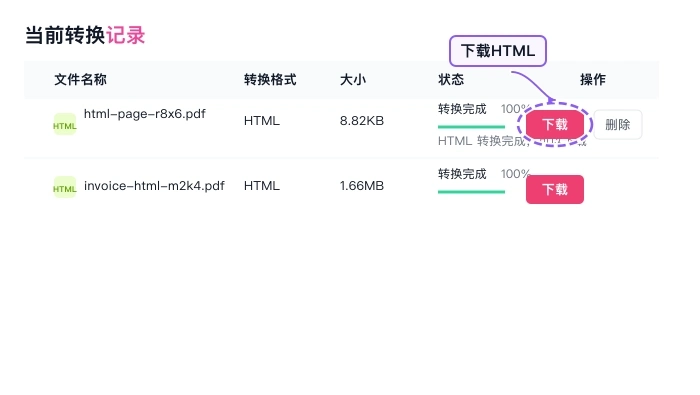
转换结束后,点击“下载”按钮获取打包后的HTML文件(通常为ZIP格式,内含主HTML及配套资源)。下载完成后不要急于归档或发布,应立即执行下一步质量核查。
方法二:采用桌面端专业软件导出网页
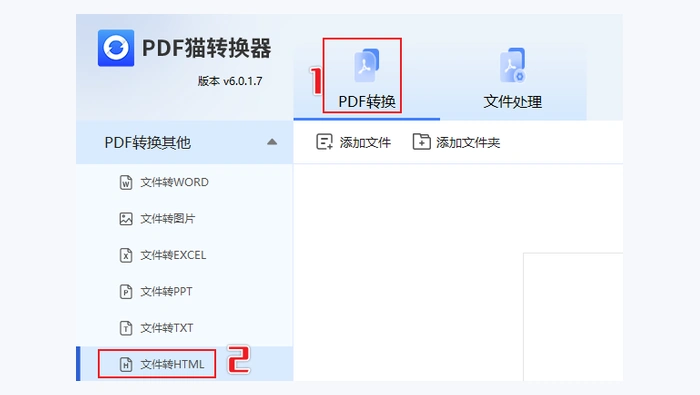
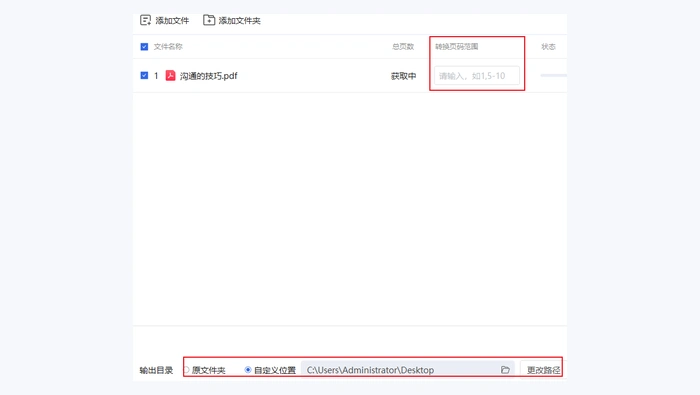
当面临大容量PDF、网络环境不稳定,或需批量处理多个文档时,本地安装的专业转换软件更具稳定性与可控性。启动软件后,请重点确认输出格式已设定为HTML,并同步检查保存路径、目标页面范围及高级选项(如嵌入字体、保留矢量图等)是否符合预期。
下述截图展示了关键操作节点:功能入口识别、文件导入确认、输出参数设定。全部配置完成后,仍须用主流浏览器打开生成结果,重点检验图片渲染、链接可达性及段落顺序一致性。
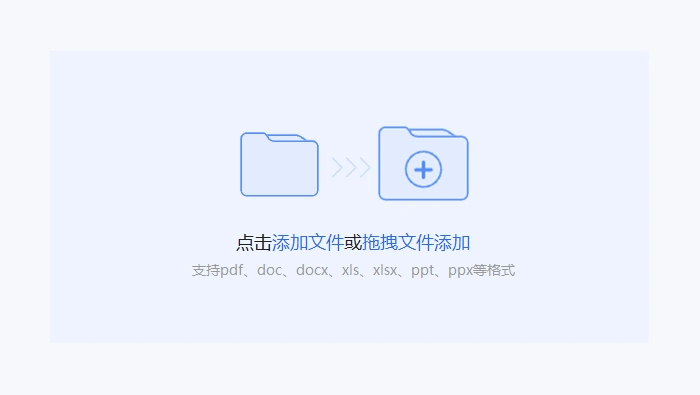
在导入阶段,请再次核对文件名、数量及上传状态,确保未混入历史版本或测试文件,方可继续后续流程。
下一环节聚焦于输出设置——重点关注格式类型、页码区间、输出目录及样式保留策略等核心参数,确认无误后再执行转换动作。
方法三:通过脚本实现固定版式批量转换
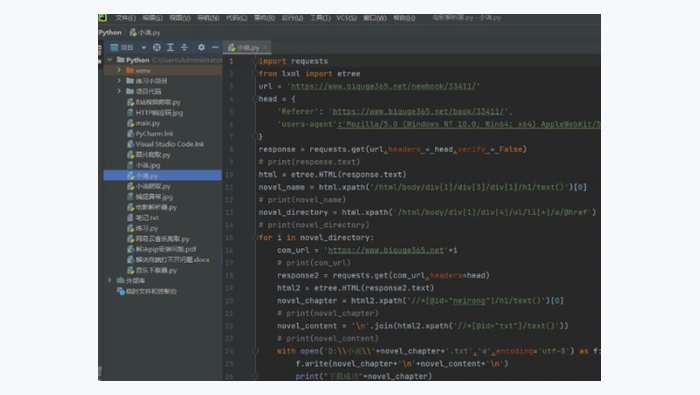
若您拥有大量结构统一、模板固定的PDF文档,且具备基础脚本编写与部署能力,可将PDF转HTML流程集成至自动化批处理体系中。需特别注意:此方式仅适用于高度标准化的文档场景;首次全量运行前,务必抽取若干样本完成全流程验证,确保HTML输出在视觉与语义层面均满足业务要求。
下图示意了典型脚本转换的工作流与输出目录结构。转换完成后,仍需人工抽检移动端适配效果及静态资源路径是否正确解析。
生成HTML后如何开展质量核查
HTML文件下载完成并不意味着流程终结。请立即在Chrome、Safari或Edge等现代浏览器中打开该文件,系统性检查以下五项核心指标:整体版式是否与原PDF一致、所有嵌入图片能否正常加载、内部及外部超链接是否可点击跳转、标题/列表/段落等结构标签是否语义准确、在手机和平板等小屏设备上是否存在错位、截断或缩放异常等问题。若发现任一环节存在偏差,应回溯至源文件或调整转换参数后重新执行。
常见失败情形应对建议
如遇上传失败、处理超时、下载中断等情况,建议首先刷新页面并重试一次。若问题持续出现,请整理如下信息发送至market@pdf.cn:PDF文件大小、具体报错截图、所用浏览器名称及版本号、完整操作步骤描述。技术支持团队将据此快速定位原因并提供针对性解决方案。
















