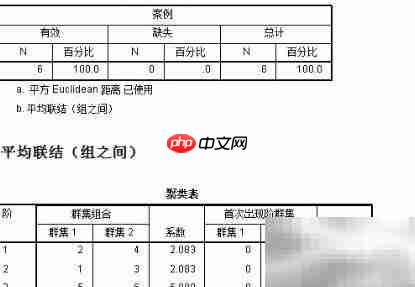
日常工作中频繁接触excel数据,但不少用户尚不掌握如何借助spss高效开展聚类分析。本文将为你梳理一套清晰、可复现的操作流程,助你快速上手并提升统计分析效率。
1、 为避免量纲差异干扰聚类结果(如GDP单位为亿元、人口密度单位为人/平方公里),必须在建模前实施无量纲化处理;若涉及有序分类变量(如评价等级),应采用数值编码方式将其转化为等距型变量,确保各类指标在算法中具备可比性与统计合理性。
2、 优秀、良好、中等、及格、不及格
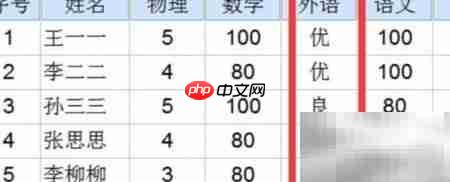
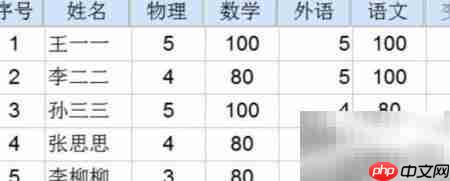
3、 将“外语成绩”字段的数据类型调整为数值型,并按等级映射规则完成赋值:优→5、良→4、中→3、及格→2、不及格→1;示例数据序列“5、5、4、4、4、2”即对应原始等级“优、优、良、良、良、及格”。
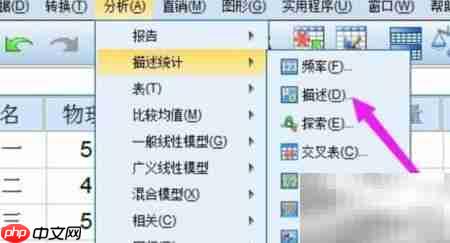
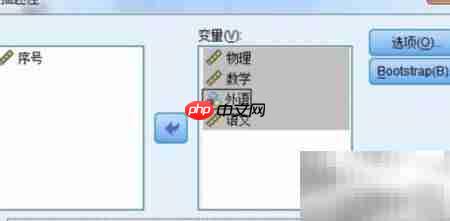
4、 在执行聚类前,需对全部分析变量进行统一预处理。进入【分析】→【描述统计】→【描述】,调出标准化设置界面。
5、 在描述统计对话框中,勾选【将标准化值另存为变量】选项,其余参数保持默认,点击确定即可批量生成Z-score标准化变量(如Z外语、ZGDP等)。
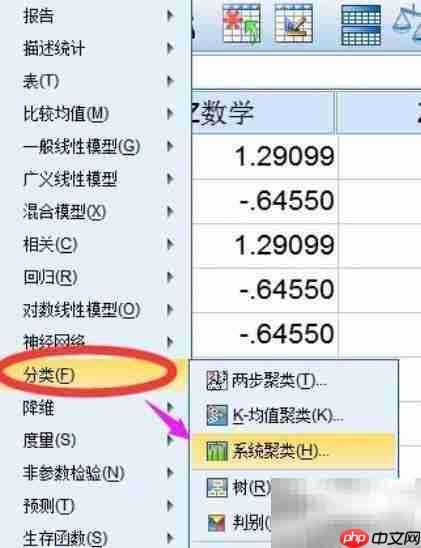
6、 接着进入聚类主模块:依次点击【分析】→【分类】→【系统聚类】,打开层次聚类配置窗口。
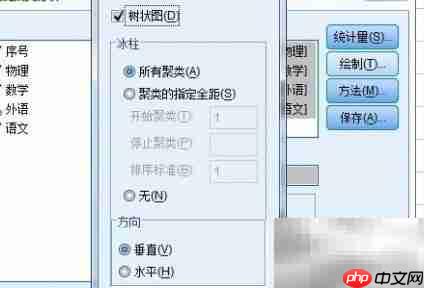
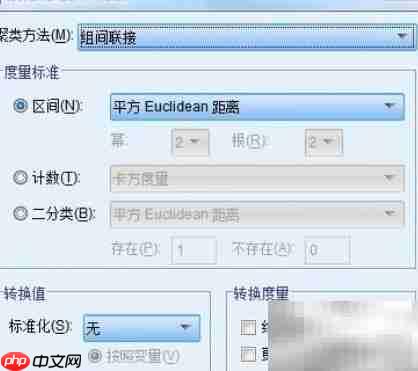
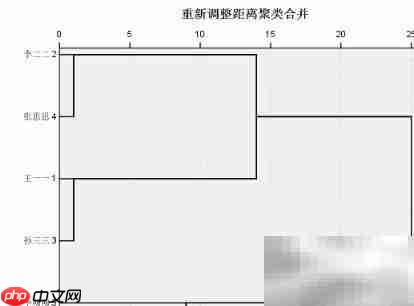
7、 在系统聚类设置面板中,将上一步生成的标准化变量全部移入【变量】框;【个案标签】处指定标识变量(如城市名或学生编号);【图】选项卡中务必勾选【谱系图】(即树状图),其他参数建议采用默认配置(组间联结法 + 平方欧式距离)。
8、 点击【确定】后,SPSS将自动完成计算并输出三类核心结果:凝聚状态表、冰柱图及谱系图。
9、 基于输出结果开展专业解读:重点关注谱系图中分支切割位置以判定最优聚类数,结合凝聚系数变化趋势辅助决策;同时利用【聚类成员】选项导出每个样本所属类别,便于后续分组对比或可视化呈现。
10、 最终分析结论即由此得出——聚类结构清晰、类别区分显著、业务解释性强。