python中如何开展数据分类与挖掘
1、 用于分类挖掘的原始数据需先进行清洗和预处理。
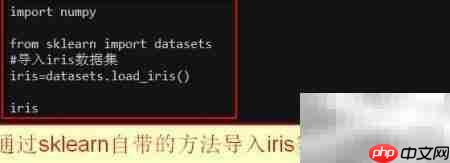
2、 可借助sklearn库自带的数据加载功能直接获取iris数据集,仅需几行代码即可完成经典数据集的导入,便于后续探索性分析与模型构建。
立即学习“Python免费学习笔记(深入)”;
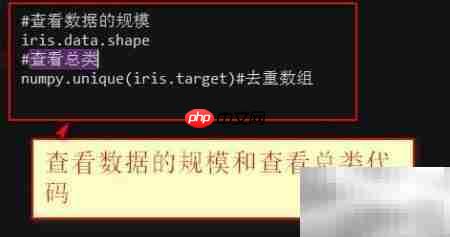
3、 检查数据维度及类别分布的常用代码示例

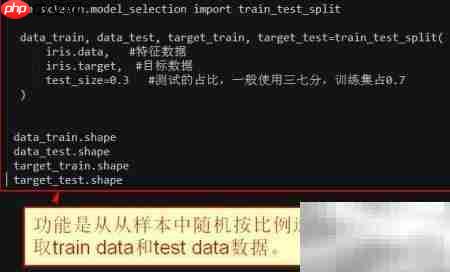
4、 train_test_split函数是模型验证环节的关键工具,支持按设定比例随机切分原始样本为训练集与测试集,有助于提升模型评估的可靠性与泛化性能。
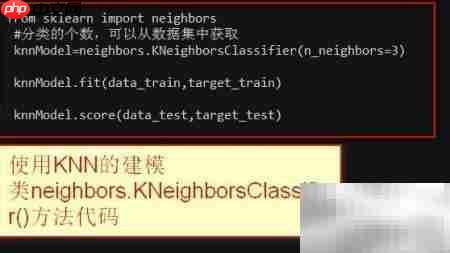
5、 基于sklearn.neighbors模块中的KNeighborsClassifier类构建K近邻分类器,通过实例化并调用fit()方法完成模型训练,实现监督式分类任务。
6、 利用cross_val_score进行多折交叉验证,并结合predict()方法对测试样本输出预测结果,全面衡量模型的实际分类效果。