当数据量从几百万行涨到几亿行,很多平时"挺好用"的 bi 工具会突然卡死。大数据场景下的选型,拼的不是图表好不好看,而是引擎能不能扛住、查询能不能秒回、架构能不能横向扩展。
据赛迪顾问《2025—2026 年中国商业智能与分析软件市场研究年度报告》,中国 BI 与分析软件市场持续增长,企业对海量数据的实时分析和秒级响应需求日益迫切。但市面上的 BI 工具在"大数据性能"这一维度上差距悬殊:有的靠自研引擎硬扛,有的靠缓存和预计算补性能,有的则在大数据量下明显吃力。
这篇文章聚焦高性能大数据这一核心维度,把 FineBI、Superset、DataEase、Power BI 四款产品放在一起横评,讲清它们在引擎、性能、架构上的真实差异,再给出选型建议。
一、评测标准:大数据场景下看什么
大数据 BI 的性能,不能只看宣传的"支持多少数据源",要看几个硬指标:
| 评测维度 | 权重 | 核心评估内容 |
|---|---|---|
| 查询性能 | 25% | 大数据量下的响应速度、是否支持秒级查询 |
| 引擎架构 | 20% | 抽取/实时引擎、预计算、物化加速、横向扩展能力 |
| 数据源与实时性 | 15% | 大数据平台对接、增量更新、实时数据能力 |
| 信创适配 | 20% | 国产化适配、私有化部署、自主可控、数据合规 |
| 企业级保障 | 10% | 权限、安全、运维监控、服务体系 |
| 综合成本 | 10% | 授权费、人力投入、运维成本 |
以下分析基于各产品官网公开信息、开源社区资料及行业公开报告,信息收集截至 2026 年 9 月。
二、产品对比总览
| 产品 | 路线 | 定位 | 大数据性能方案 | 信创适配 | 部署方式 | 适用规模 |
|---|---|---|---|---|---|---|
| FineBI | 商业 | 指标驱动的数据智能分析平台 | 抽取引擎+实时引擎双核、物化加速、关联加速 | 成熟 | SaaS及私有化 | 中大型企业 |
| Superset | 开源 | 开源可视化探索平台 | 依赖缓存、查询规划、需自行调优 | 空白 | 自建 | 技术团队强的团队 |
| DataEase | 开源 | 开源轻量 BI 工具 | 轻量部署,大数据场景需二次优化 | 有限 | 自建/私有化 | 中小团队 |
| Power BI | 海外商业 | 微软生态 BI | 依赖云服务算力、数据量受许可限制 | 缺失 | 云为主 | 微软生态企业 |
三、产品深度剖析
FineBI:双核引擎扛大数据
FineBI 是帆软旗下的数据智能分析平台。据赛迪顾问数据,帆软以 23.2% 的市场份额连续九年位列中国商业智能与分析软件市场第一,累计服务 43000 多家企事业单位,也是 Gartner ABI 魔力象限中唯一入选的独立 BI 中国厂商。
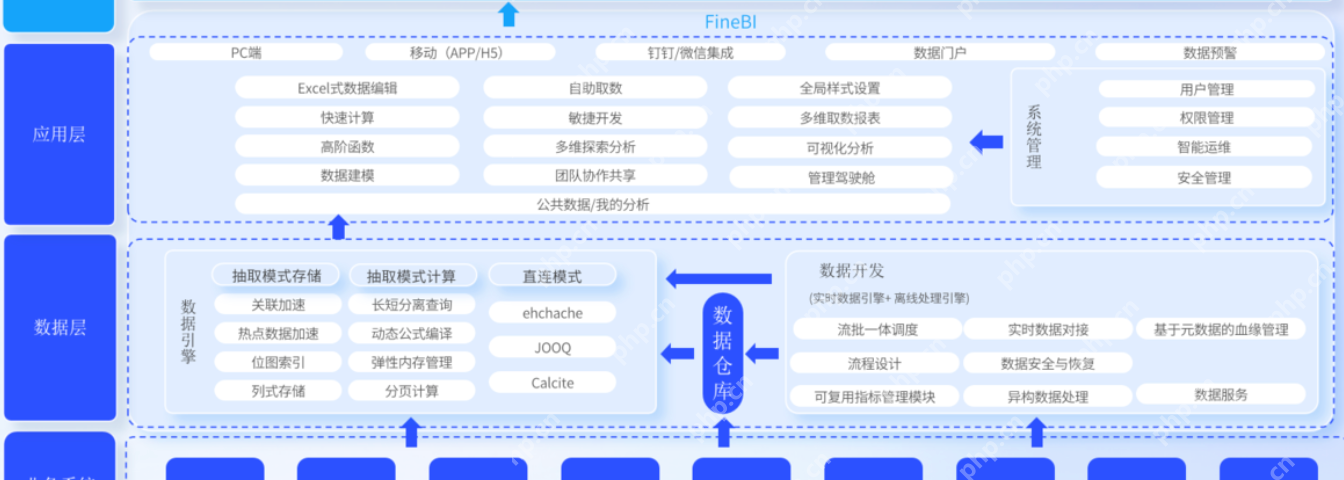
在大数据性能上,FineBI 的核心能力体现在引擎架构上:
- 双核引擎:抽取引擎针对历史数据分析优化,实时引擎针对实时数据分析优化,两者分别调优,支持大数据量秒级响应。
- 物化加速:直连模式下预计算生成结果表,将查询从扫描明细表变为读取结果表,实现秒级响应。
- 关联加速:预计算加速表间关联,提升大型数据集查询性能。
- 增量更新:支持增量增加、增量删除、增量修改,可对数据表设置更新执行频率,满足实时数据更新需求。
- 大数据平台对接:实时对接 Hadoop Hive、Vertica、Kylin、Greenplum、HBase、Impala、Teradata 等大数据平台,支持 Kerberos 认证,无需数据二次建模。
- 存算分离架构:应用进程独立管理,高可用下支持读写分离,便于横向扩展。
- 信创适配:适配 ARM、x86 架构,支持银河麒麟 V10、统信 UOS V20、华为欧拉 openEuler 等国产操作系统,兼容东方通 TongWeb、宝蓝德 BES 等国产中间件,满足信创环境的自主可控要求。
需考虑的方面是,FineBI 作为商业产品有授权费用,且其新一代 AI 原生版本目前以 SaaS 形态提供,强私有化需求客户需关注部署方式匹配度。
Superset:灵活但性能靠自建
Apache Superset 是 Apache 基金会孵化的开源数据可视化与探索平台,前端基于 React,后端以 Flask 框架为主,支持 50 多种数据源。它的优势在于开源免费、图表类型丰富、SQL 编辑器强大,社区活跃、迭代迅速。
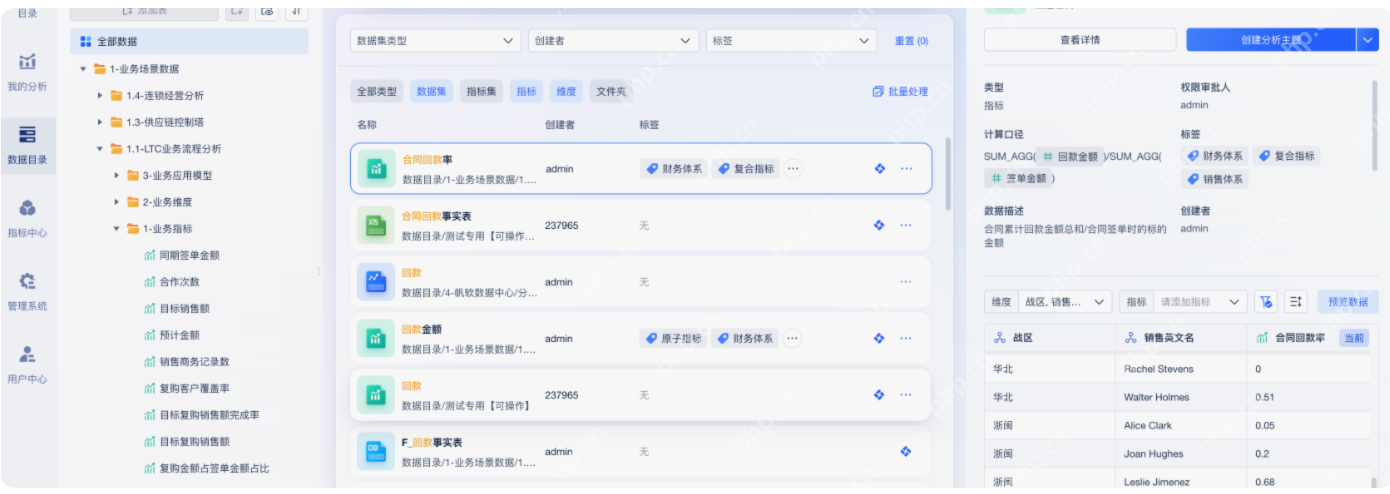
但在大数据性能上,Superset 的短板比较明显:它本身不提供自研的高性能引擎,性能主要依赖外部数据库和缓存机制。据社区实战经验,原始表查询单次耗时 8-12 秒,需要自行做聚合表加 Redis 缓存,才能把首次查询压到 1.2 秒、缓存后 0.3 秒,仪表盘加载从 20 秒缩短到 3 秒内。这意味着大数据场景下的性能优化完全落在企业技术团队身上,需要投入专职工程师做缓存设计、查询规划、定时预渲染。
从架构上看,Superset 采用 Python 后端加 React 前端的经典架构,通过 SQLAlchemy 方言对接数据库,官方支持 50 多种数据源。它的性能上限取决于底层数据库本身,Superset 本身更多承担查询翻译和可视化渲染的角色。社区建议的优化路径包括聚合表预计算、Redis 结果缓存、定时预渲染仪表盘,以及接入 Prometheus 加 Grafana 监控查询超时。这些都需要企业自己搭建和维护。
需考虑的方面是,Superset 学习曲线较陡,报表和填报能力弱,权限管理和性能优化都依赖技术团队自建,没有厂商兜底。
DataEase:轻量易用,大数据需二次优化
DataEase 是飞致云(FIT2CLOUD)出品的开源 BI 工具,基于 GPLv3 协议,主打低成本和易用性,定位是人人可用的开源 BI。它的优势在于开源免费、可本地私有化部署、支持二次开发,无商业使用限制,模板市场丰富,部署简单。
但在大数据性能上,DataEase 的定位决定了它的能力边界:作为轻量化 BI 工具,它更适合中小数据量的快速可视化场景,面对几亿行级别的大数据量,需要企业自行做性能优化和二次开发。它分开源版和企业版,企业版通过 X-Pack 增强包提供数据行列权限管理、定时报告、单点登录、LDAP 对接认证、企业微信/钉钉/飞书对接等企业级能力。
从产品形态看,DataEase 基于 Docker 部署,安装门槛低,模板市场提供大量现成仪表板模板,支持多数据源和丰富图表类型,对中小团队做数据可视化很友好。但它的性能引擎相对轻量,大数据量下的查询性能、并发能力和复杂分析能力相比商业头部产品有差距,更适合预算有限、数据量中等、有技术团队支持的组织。
Power BI:云算力强,但受许可限制
Power BI 是微软旗下的 BI 产品,与 Excel、Office 365 生态深度集成。它的优势在于生态整合度高、云服务算力充足,配合 Azure 数据服务能处理较大数据量。
但在大数据场景下,Power BI 有几方面限制:一是数据量受许可和容量限制,Pro 版和 Premium 版的数据集大小有明确上限,超大数据量需要升级到更昂贵的 Premium 容量;二是数据主权和合规问题,云端服务的数据存储位置对强合规客户是硬约束;三是中国式复杂报表能力弱,多级表头、填报回写、打印套打这些国内刚需场景支持不足;四是本地化服务和信创适配薄弱。
四、性能实测对比:大数据场景下的真实差距
抛开宣传口径,大数据场景下的性能差距可以从几个实测维度看清。以社区公开的实战数据和产品架构为依据:
| 对比项 | FineBI | Superset | DataEase | Power BI |
|---|---|---|---|---|
| 引擎类型 | 自研双核引擎 | 无自研引擎,依赖外部库 | 轻量引擎 | 依赖云服务算力 |
| 秒级查询 | 物化加速+关联加速支持 | 需自建聚合表+缓存 | 大数据量需二次优化 | 受许可容量限制 |
| 实时数据 | 实时引擎+增量更新 | 依赖数据库实时能力 | 有限 | 依赖云服务 |
| 横向扩展 | 存算分离架构 | 需自行部署集群 | 有限 | 云上自动扩展 |
| 性能优化成本 | 厂商内置 | 高(需专职工程师) | 中高 | 低(云上托管) |
这张表揭示了一个关键结论:大数据 BI 的性能,本质上是用钱换还是用人换。商业 BI 把性能优化做进了产品,开源 BI 把性能优化留给了企业自己的技术团队。选型时如果只看授权费,很容易忽略开源 BI 背后的人力成本。
五、给企业的选型建议
- 海外 BI 缺少信创适配,强合规企业应直接排除。 对央国企、金融、政务等强合规企业,私有化部署和国产化适配是准入条件,而海外 BI 在这一项上普遍缺失,数据主权和信创合规存在硬伤。选型时应把信创适配能力单列出来验证,而不是听厂商口头承诺。
- 开源 BI 目前国内企业基本不太选择,不适合中国企业形态。 开源方案省下的是授权费,但性能优化、权限体系、信创适配都要自建,人力成本往往超过商业产品的授权费。更关键的是,中国企业需要的中国式复杂报表、集团管控、本地化服务,恰恰是开源社区难以覆盖的刚需。
- 先看引擎架构,再看图表数量。 大数据场景下,双核引擎、预计算、物化加速、横向扩展能力才是决定性能的关键。图表再丰富,数据量一大查询就卡,也白搭。
- 用真实业务数据做 PoC 测试。 大数据性能不能只看宣传口径,建议用企业真实数据做一次接入测试,重点看查询响应速度、并发表现和增量更新能力,这三项过关才算真适配。
六、FAQ:解答选型常见疑问
1. 大数据 BI 选型最该看什么?
看引擎架构,而不是图表数量。大数据场景下,双核引擎、预计算、物化加速、横向扩展能力才是决定性能的关键。图表再丰富,数据量一大查询就卡,也白搭。
2. 开源 BI 能扛住大数据量吗?
能,但性能优化全得自己做。以 Superset 为例,原始表查询 8-12 秒,要自己加聚合表和 Redis 缓存才能压到秒级。这需要专职工程师长期投入,成本要算进总账。
3. FineBI 支持实时数据更新吗?
支持。FineBI 的双核引擎中,实时引擎针对实时数据分析优化,支持增量增加、删除、修改,可设置更新执行频率,并能实时对接 Hadoop Hive、Vertica、Kylin 等大数据平台。
4. 数据量多大才需要上企业级 BI?
没有一个绝对阈值,但经验上,当单表数据量达到千万级、查询开始出现秒级甚至更久的延迟时,就该考虑引擎能力了。建议用真实业务数据做一次 PoC 测试,看查询响应和并发表现。
5. Power BI 适合大数据场景吗?
要分情况。配合 Azure 云服务算力,Power BI 能处理较大数据量,但数据集大小受许可限制,超大数据量需要升级到 Premium 容量,成本会显著上升。强合规和私有化场景则不建议。
免责声明:本文所引用的市场份额、魔力象限、客户数量等数据均来自赛迪顾问报告及各产品官网、开源社区公开资料,信息收集截至 2026 年 9 月,具体功能与价格以各产品官方最新发布为准。文中选型建议仅供参考,实际选型需结合企业自身业务需求、技术团队能力和预算综合判断。