


9月21日,通义千问团队正式对外发布全新升级的开源图像生成模型——qwen-image-2.1。该模型以仅70亿参数的轻量化视觉生成模块为核心,首次将文本到图像生成、透明通道图像输出及多样化图像编辑功能统一整合至单一架构中,在画质表现、运行速度与资源消耗三者之间实现了更优协同。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
根据官方技术文档,Qwen-Image-2.1 的视觉生成主干采用32层单流 DiT(Diffusion Transformer)结构,总参数量严格控制在7B以内。依托混合尺度注意力机制与 KV Cache 共享策略,模型在处理多图输入任务时推理吞吐量显著增强,同时大幅降低显存占用压力。
支持 RGBA 透明通道输出是本次版本迭代的关键突破。模型可根据用户提示词智能识别并决定输出标准 RGB 图像或含 Alpha 通道的透明图像,并可在维持原始透明背景不变的前提下,对主体面部表情、叠加文字等内容进行精准调控。此外,用户还可上传实拍照片,由模型自动完成主体分割与透明图层提取,为后续平面设计、视频合成等场景提供高质量素材支持。
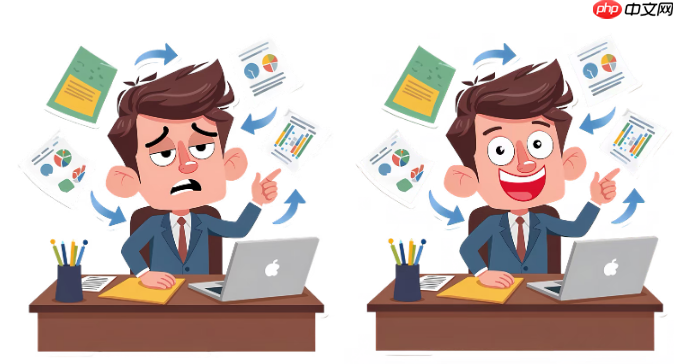
在保留原有透明背景的基础上,实现主体表情的自然调整

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
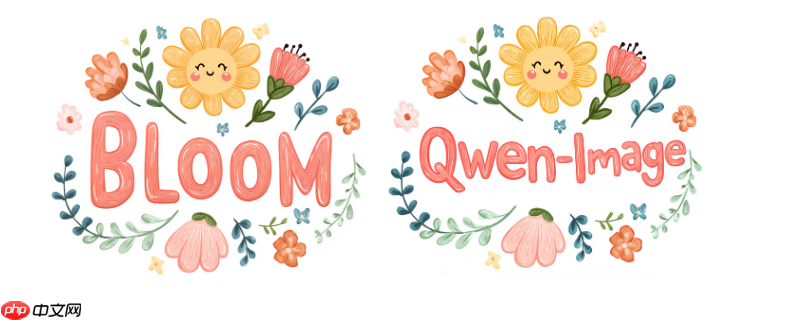
透明图层中的文本内容亦支持实时编辑,例如下图即将原文字“BLOOM”替换为“Qwen-Image”:
在图像编辑能力方面,Qwen-Image-2.1 最高支持同时接入10张参考图像,能够融合多个对象特征与风格元素,生成逻辑统一、构图协调的新图像。局部编辑提供圈选区域、涂抹遮罩及自定义掩码三种交互方式,使编辑范围设定更为直观灵活。模型还重点优化了人像与商品类图像的一致性建模能力——修图后的人物五官结构、商品标识文字及产品形态均能高度保真还原。
与此同时,该模型在文本渲染清晰度、人物光影层次感以及微观细节刻画等方面均有明显进步,可稳定适配全景构图、数据可视化图表、分镜脚本图等多种专业图像生成需求。目前,Qwen-Image-2.1 已全面开源,开发者与创作者可通过 GitHub、ModelScope 及 Hugging Face 等主流平台免费获取模型权重与配套代码。












