


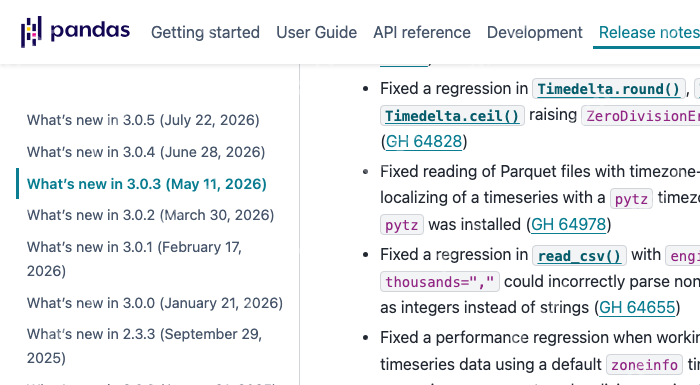
pandas 3.0.3 正式版2026年5月11日发布,官方更新说明里列了一批修复项,覆盖时区、工作日日期范围、to_timedelta()、字符串数据类型、时间序列几个方向。从pandas 3.0.0开始,官方就默认用标准库的zoneinfo或者datetime.timezone表示时区,这次3.0.3又做了一致性对齐:所有底层走pyarrow的i/o方法,返回时区的逻辑全部统一,涉及的接口包括read_parquet()、read_feather()、read_orc(),还有指定了对应引擎的read_csv()。
来源:Pandas 官方发布说明
这个改动对依赖Parquet、Feather、ORC,或是用Arrow CSV引擎的数据链路来说影响很实际。之前同一个时间字段,走不同读取路径可能返回完全不同的时区对象,测试的时候经常莫名其妙出现类型不匹配、序列化结果对不上的问题。3.0.3相当于把这几个I/O接口的行为全部对齐到3.0系列的默认时区规则,能大幅降低同一个项目里「内存手动生成的时间数据」和「读文件出来的结果」不一致的概率。
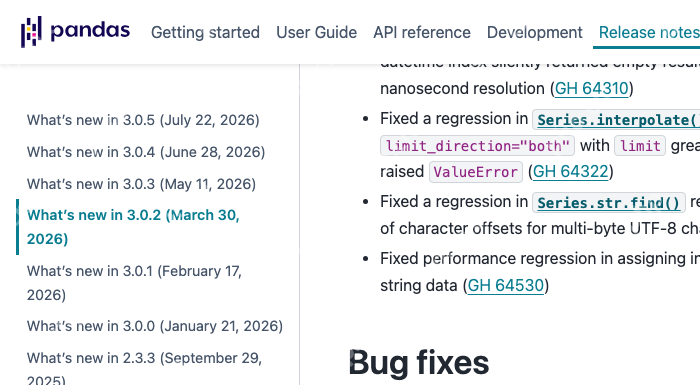
更早的Pandas 3.0.2版本,也在3.0大版本上线后持续做增强和修复,官方更新说明里记录了不少回归问题修正和bug修复。把3.0.2和3.0.3的更新内容连起来看就能发现,3.0系列早期的重点根本不是堆新功能,而是围绕新默认字符串类型、Copy-on-Write、时区、时间序列和I/O行为,把之前没捋顺的边界逻辑补全。对长期稳定运行的数据任务来说,这类底层补丁的价值往往比表面上新出的API要高得多。
来源:Pandas 官方发布说明
实际升级的时候,建议大家重点做几部分回归校验:读文件后的时区对象类型、时间戳比对逻辑、分组聚合结果、日期范围生成,还有数据导出后再重新读入的全链路闭环结果。如果你的项目里同时混着pytz、zoneinfo和固定偏移量时区的写法,升级前一定要把不同来源的数据样本都覆盖测试到。官方没把3.0.3标注为破坏性新版本,但它调整的刚好是数据工程里最容易被忽略的时间一致性环节。
信源说明:本文依据Pandas 3.0.3与3.0.2官方发布说明撰写;涉及时区和I/O的实际行为,建议结合项目真实数据和官方最新文档验证。














