


pandas 官方的发布说明页面已经把 3.0 系列标为当前主线版本,页面里列了 3.0.5、3.0.4、3.0.3、3.0.2、3.0.1 和 3.0.0 所有正式版本节点。打算升级的数据团队可以直接参考这个信息:pandas 3.0 不是只发个初版就完事,2026 年上半年一直在修复回归问题、补齐兼容性缺口。生产环境要不要升级,不能光看“主版本已发布”就拍板,得结合官方发布说明、自身测试覆盖情况、全依赖链的校验结果综合判断。
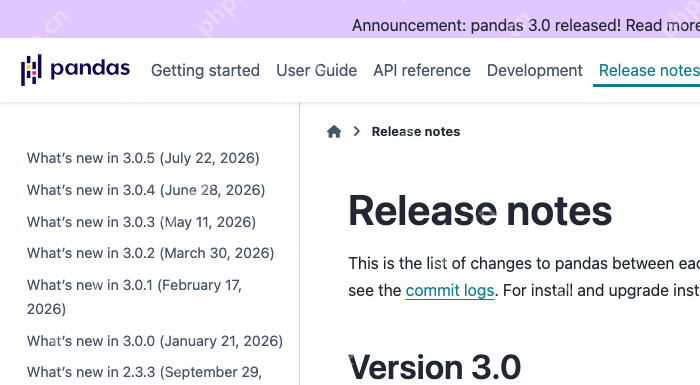
来源:Pandas 官方发布说明
Pandas 官方博客在升级指南里给了个非常实在的建议:先把版本升到 Pandas 2.3,确认代码完全跑通、没有任何警告之后,再往 Pandas 3.0 升。这不是走流程的客套提醒:3.0 直接移除了之前版本里早就标记弃用的功能,还调整了字符串 dtype 和 Copy-on-Write 的底层行为。要是项目没提前把旧警告清理完,直接升级的时候很容易把弃用报错、行为变化、依赖冲突堆在一起,根本分不清哪出的问题。
现在官方安装文档仍然把 conda-forge 等渠道列为推荐安装方式之一。对企业内部环境来说,安装渠道本身不算什么新鲜事,但这点能提醒维护者,升级的时候得同步检查 Python、NumPy、PyArrow、各类数据库驱动还有内部私有镜像源。Pandas 3.0 的改动涉及类型推断和 I/O 读写逻辑,光单独替换 pandas 包根本不够,必须把数据读取、写出、类型转换和 SQL 接口全纳入回归测试范围。
来源:Pandas 官方安装文档
从实际开发踩坑的反馈来看,升级后最容易出问题的区域包括字符串列判断、链式赋值、内存副本共享、时间数据精度、缺失值处理,以及第三方库对 pandas 新 dtype 的适配。官方发布说明提供了逐版本的完整变更列表,建议团队把升级拆成两步:先在 2.3 版本上清理完所有告警,再切到 3.0 的测试分支里逐项核对行为变化。这么做虽然多花点时间,但能大幅降低一次性跨主版本升级的问题排查成本。
信源说明:本文依据 Pandas 官方 Release notes、Pandas 3.0 官方博客和安装文档撰写;是否升级应以项目自身测试结果和官方最新发布说明为准。









