性能持续攀升,功耗稳步下降:深度解析骁龙新一代旗舰芯片的能效演进逻辑
骁龙峰会临近,高通打破过往一贯的保密传统,在短短两周内接连发布两篇技术深度博文:8月25日聚焦CPU架构,9月2日详解GPU升级。GHz级主频、1.45GHz GPU运行频率、Matrix Cores等硬核参数集中曝光,引发数码圈广泛关注。然而若细读这两份官方文档,会发现一个高频词始终贯穿始终——功耗。
这绝非偶然,而是高通有意识的战略转向:功耗正从规格表中不起眼的一行参数,跃升为衡量本代芯片实际体验的核心标尺。
 2nm:数字背后的真实物理跃迁
产业链多方确认,全新骁龙旗舰全系采用N2P(2nm增强型)制程工艺,这也是高通首款落地商用的2nm移动平台。相较前代3nm,晶体管密度提升约30%,在同等性能下功耗降低36%,而在相同功耗约束下性能提升达18%。36%这一数值意义重大——它意味着:续航不变的前提下,性能释放更激进;性能需求不变时,整机温控更从容、电池寿命更持久。
CPU:5GHz只是表象,功耗控制才是本质
5GHz主频无疑是CPU技术博文中最抓眼球的数据,但真正体现设计功力的,却是后半部分关于能效调控的细节。高通在自研Oryon CPU上实现了两大关键突破:
其一是“独立时钟域”机制。作为全定制核心,每个Oryon CPU单元均配备专属时钟域,支持按需独立调频。系统可依据负载类型与强度,精准唤醒特定核心——轻量任务仅启用高效能小核,重载场景则仅拉升超大核频率。高通真正的进步,并非单纯追求“跑得多快”,而在于“控得多准”:按需供电,毫瓦不冗余。
其二是FlexCache缓存架构。传统设计中,核心频繁访问系统内存本身即构成显著能耗来源。FlexCache将L2缓存重构为全域共享资源池,大幅提升数据驻留率,显著减少跨层级内存访问次数。高通的设计哲学清晰可见:先进制程负责“开源节流”,先进架构则确保每一份节省下来的功耗都物尽其用。
 GPU:把功耗优化变成一道可计算的AI方程
GPU技术博文对功耗的刻画更为量化:新Adreno GPU延续三切片设计,频率由1.2GHz跃升至1.45GHz。但真正驱动能效跃升的,是三项结构性创新:
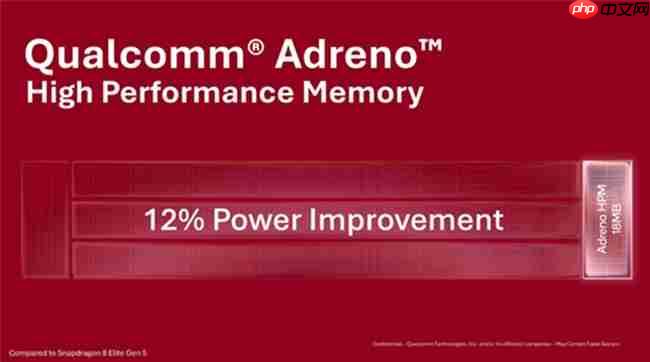
第一项是18MB HPM(High-Performance Memory)片上高速显存。图形渲染过程中的中间帧、纹理、指令等关键数据直接驻留于片上,大幅削减与系统内存之间的数据搬运频次。据高通实测,该方案可带来约12%的功耗优化。
第二项是Matrix Cores矩阵计算单元。这是Adreno GPU首次集成面向AI推理的专用硬件模块,使轻量级AI模型可原生嵌入图形处理流水线,避免数据在GPU、NPU、内存之间反复迁移——每一次路径压缩,最终都转化为实实在在的能耗下降。
第三项是Adreno Neural Fusion技术。依托Matrix Cores,AI超分与帧生成能力深度融入渲染链路,相较上一代独立AI加速方案,最高可实现40%的功耗降幅。12%叠加40%,让高画质游戏运行更持久、更冷静。
 为何功耗成为本代叙事主线?
高通为何倾注如此多精力打磨功耗?答案或许比预想更直白——功耗,正决定终端侧AI的落地纵深。
从CPU调度到GPU渲染,从FlexCache到Neural Fusion,高通在每一篇技术文档中反复践行同一逻辑:以最小能耗承载最大智能负载。因为未来的智能体(Agent)应用,要求手机本地实时完成语音理解、图像识别、多模态融合推理及复杂任务协同调度——这些能力带来的功耗压力呈指数增长。若底层芯片缺乏精细化功耗管理能力,再亮眼的AI参数也终将受限于发热、降频与续航坍塌,沦为纸上谈兵。
本代骁龙真正构建的竞争壁垒,并非堆砌算力峰值,而是将能效比本身锻造成AI时代的底层竞争力。