微信 ai 官方于 9 月 4 日正式宣布,开源通用多模态嵌入模型 wemm-embedding,涵盖 2b、4b、9b 三种参数规模版本,全面支持文本、图像、视频、视觉文档以及任意混合排列的多模态输入。
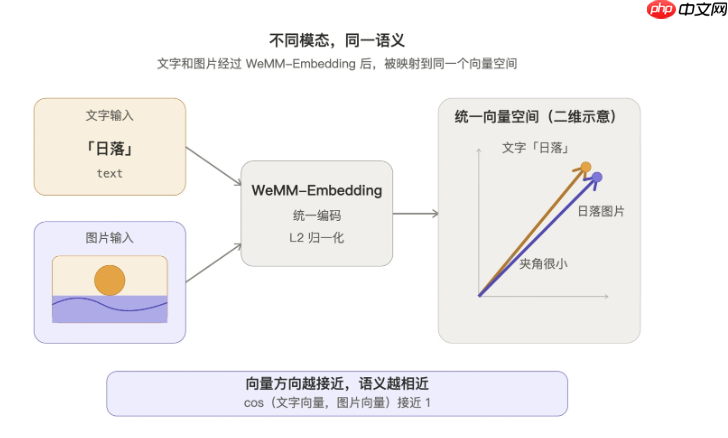
据微信内部员工 @客村小蒋 分享,该模型由微信视觉团队研发,其核心能力在于实现文字、图片与视频等异构信息的统一语义建模——即将不同模态的数据映射至同一向量空间,从而支撑跨模态的比对、检索与理解。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

微信公众号推文写作助手
下载
微信公众号推文写作与发布助手。支持深度文章撰写(1500+ 字)、智能配图搜索、API 配置引导、草稿箱上传、一键排版等全流程功能。 每篇文章默认 1500 字以上,配备 1 张相关配图(放在第一段后),包含清晰的分段标题结构。
已深度集成至多项核心业务场景
他表示,WeMM-Embedding 已在微信生态内实现规模化部署,广泛应用于朋友圈搜索、视频号内容推荐、公众号文章分发及微信电商商品理解等关键环节,日均调用量高达 10 亿次。在国际权威多模态评测基准 MMEB-v2 中,该模型综合表现位居榜首,力压此前所有公开及未公开的竞品模型。
目前,WeMM-Embedding 的全部技术资料均已开放:论文已发布于 arXiv 平台;源代码托管于 GitHub 上的 Tencent/WeMM-Embedding 仓库;预训练模型权重也同步上线 Hugging Face 模型库。